凌晨两点被拉进语音会,通常没好事。那次是慢查询。订单列表接口,白天还行,晚高峰直接拖垮连接池。看执行计划,type=ALL,扫描行数七位数。开发第一反应:加索引。我理解。但别急。数据库索引不是止痛片,吃多了伤肝。

先把话说清楚。数据库索引干的事,是把无序数据变成可快速定位的有序结构。B+树也好,LSM 里的跳表、布隆过滤器也好,本质都在减少磁盘随机读。磁盘最怕随机。机械盘时代一次寻道几毫秒,SSD 好点,但也不是不要钱。索引让查询从全表扫,变成沿着树根往下走。三层 B+树,根节点常驻内存,中间节点大概率缓存,最后一层叶子页读盘。听上去很美。
写入路径先被改写
麻烦在于,读的便宜,是用写的贵换来的。每建一个二级索引,插入、更新、删除都要多维护一棵树。你以为只加了一个字段?不是。写放大跟着来。插入一条记录,聚簇索引要定位,二级索引也要定位。页满了就分裂。分裂不是优雅舞蹈,是挪数据、申请新页、改父节点指针。随机主键更糟。UUID 当主键,插入点乱跳,页分裂频繁,碎片一堆。
所以有个反直觉的点:数据库索引优化,很多时候先看写入模式,再看查询。如果这张表写多读少,索引加得爽,写入延迟会教你做人。自增主键为什么常见?不光是简单。它让插入集中在最右页,减少分裂。分布式系统里没法简单自增,那是另一个取舍。别把单机经验直接搬过去。

回表这件事 绕不过去
InnoDB 的聚簇索引,叶子节点存整行。二级索引叶子存索引列加主键值。于是查二级索引拿到主键,再去聚簇索引捞整行。这叫回表。一次查询,两棵树。如果二级索引过滤后剩很多行,回表可能比全表扫还慢。优化器不傻,它会算。但统计信息一偏,算盘就打歪。
覆盖索引能省掉回表。查询需要的列都在索引里,直接返回。比如联合索引覆盖 where、order by、select 的列。听起来像银弹?也不是。索引越宽,页越大,缓存命中越差,写入越重。把大字段塞进索引,纯属给存储和内存找事。写入延迟容易涨,查询未必快。何必。
复合索引还有个老话题:最左前缀。where 条件从索引第一列开始连续匹配,才能有效利用。跳过第一列,后面列很难单独用上。范围查询之后的列,通常只能过滤,不能继续定位。这些规则不新鲜。新鲜的是,很多人建了索引,却不看执行计划。explain 里 key 是空的,rows 照样大。索引在那躺着,优化器不用。为什么?可能类型隐式转换,可能对列用了函数,可能选择性太差。
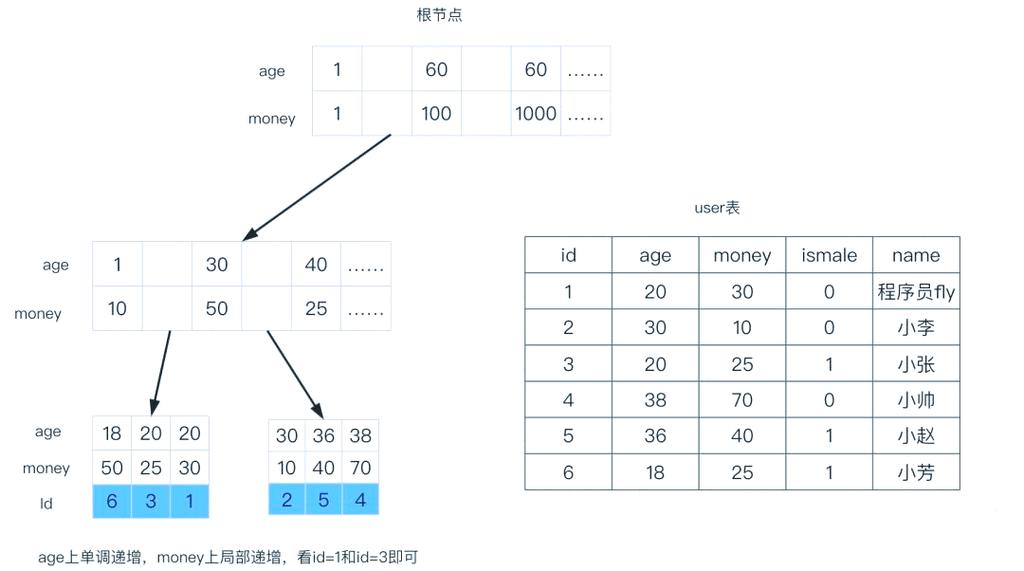
选择性不是玄学 是算账
选择性,说白了就是这列能过滤掉多少。性别列,只有两三个值,索引扫一半,不如不扫。订单状态列,如果九成都是已完成,查未完成也许有用,查已完成就废。可业务是变的。今天九成已完成,明天可能一半退款。索引策略得跟着数据分布走。统计信息过期,优化器就会按老黄历办事。
定期看统计信息,比盲目加索引有用。MySQL 有 analyze table,PostgreSQL 有 autovacuum 和 analyze。别等慢查询堆积才想起。还有冗余索引。A 索引和 A,B 联合索引,如果查询只用 A,前者可能冗余。但也不绝对。索引越小,缓存越友好。删索引比加索引更需要勇气,因为出事时第一个被怀疑。
再说执行计划。别只看 type。看 key、key_len、rows、filtered、Extra。Using index 是覆盖,Using where 是服务层过滤,Using filesort 和 Using temporary 要警惕。但执行计划不是判决书。数据量、参数、绑定变量、缓存,都会让计划漂移。生产慢,测试快,这种事太常见。采样、压测、影子流量,能上就上。
索引不止 B+树
数据库索引不是只有 B+树。哈希索引适合等值查询,范围查询直接跪。位图索引在低基数、分析场景有位置,但高并发更新容易锁到怀疑人生。倒排索引给全文检索用,Lucene、Elasticsearch 那套和关系库不是一回事。LSM 树呢?写多读少时很香。内存里维护 MemTable,落盘成 SSTable,布隆过滤器帮忙判断 key 在不在。代价是读放大、压缩、 compaction。没有免费午餐。
所以选型时先问:读写比例多少?查询模式是点查、范围、聚合、全文?一致性要求多高?延迟预算多少?这些问题不回答,直接问“加什么索引”,等于问医生“我该吃什么药”但不给症状。数据库索引是物理设计的一部分,不是 SQL 末尾的装饰。
还有索引下推、索引合并、自适应哈希索引这些优化器特性。不同版本行为不同。升级数据库时,执行计划可能悄悄变。别问为什么,问就是统计信息、优化器规则、参数默认值。留个基线,跑回归。慢查询日志开起来。performance_schema 和 pg_stat_statements 用起来。工具不贵,贵的是不看。
删掉不用的 比新建更难
维护索引像整理房间。加东西容易,扔东西难。每个索引都有写入成本、存储成本、备份成本、DDL 成本。大表加索引,在线 DDL 也可能抖。MySQL 8 有 instant add column,但加索引通常还是要构建。业务低峰期、gh-ost、pt-online-schema-change,都是办法。但办法有代价。锁、复制延迟、磁盘 IO,一个都跑不了。
怎么判断索引没用?看统计。sys.schema_unused_indexes、pg_stat_user_indexes,能给出线索。但别一刀切。有些索引只在月底报表用,平时零命中。删了,月底出事。所以得结合业务日历。说实话,这活很琐碎。没有一劳永逸。
回到开头那个慢查询。最后不是只加索引。我们把查询改了,去掉了不必要的排序,把联合索引列顺序调了,又删了两个冗余索引。写入延迟没涨,读也稳了。数据库索引的收益,常常来自少而准,不是多而全。索引是拿空间和写入换读取。这个交换划不划算,只有业务知道。别迷信规则。看数据。看计划。看代价。
凌晨三点的语音会散了。第二天还得看慢查询日志。数据库索引这事,没完。