几年前我跟一个运维团队蹲过一晚上。线上服务挂了。查到最后,问题不在代码,不在网络,在一台物理机的内核参数上——有人两个月前改过一个值,没写进任何文档,也没进任何配置管理系统。重启之后才暴露。
那时候他们刚开始推容器化。我印象很深,负责人说了一句:以后这玩意儿进镜像里,机器就干净了。
机器确实干净了。但事情真的变简单了吗。
隔离这件事比想象中薄
容器不是虚拟机。这话被说烂了,但很多人没真正理解它的分量。namespaces 隔离的是视图,cgroups 限制的是资源使用,它们共用同一个内核。你在容器里看到的进程号,是宿主映射过来的。你在容器里看到的文件系统,是挂载命名空间拼出来的。说白了,就是一层精心设计的伪装。
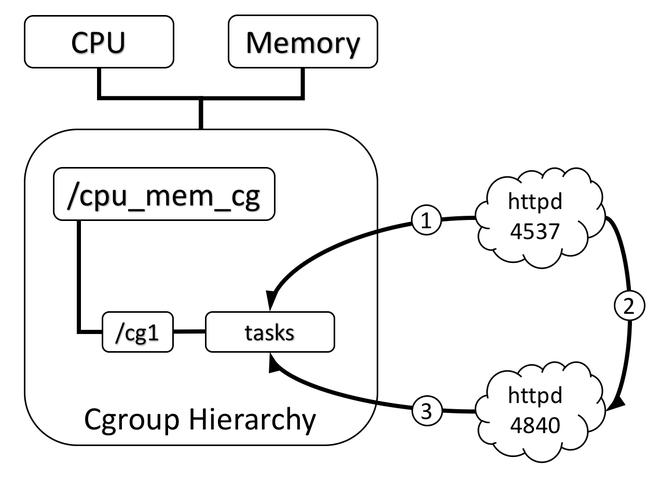
有个坑我见过不止一次。生产容器里跑了某个采集脚本,读 /proc 下的系统信息,采集到的其实是宿主机的数据。开发觉得没问题,因为本地跑的时候对得上;上线之后指标全歪了。问题不在容器化本身,在于我们习惯了一些默认假设,而这些假设在隔离边界上不成立。
麻烦在于,这种假设很隐蔽。你不掉进一次坑,根本不会主动去查。
内核参数也是。sysctl 一部分是命名空间化的,一部分不是。你想调的 net.core.somaxconn,在老版本内核里是全局的。容器里调了,等于给整台机器调了。这事没那么玄,但你得知道哪些能动、哪些不能动。玩容器,某种程度上是在补操作系统课。
镜像是个层层叠叠的东西
Dockerfile 写起来太顺手了。一行 RUN,一行 COPY,构建缓存一命中,秒出。顺手的东西往往藏着代价。
镜像分层机制本身很聪明。每一层是只读的,构建时复用,推拉时只传变更。但这也意味着,你在某一层里放了敏感文件,后面删掉,它还在前面的层里。镜像扫得到。删是删不干净的。你得从源头就不写进去,用多阶段构建,把构建环境跟运行环境分开。
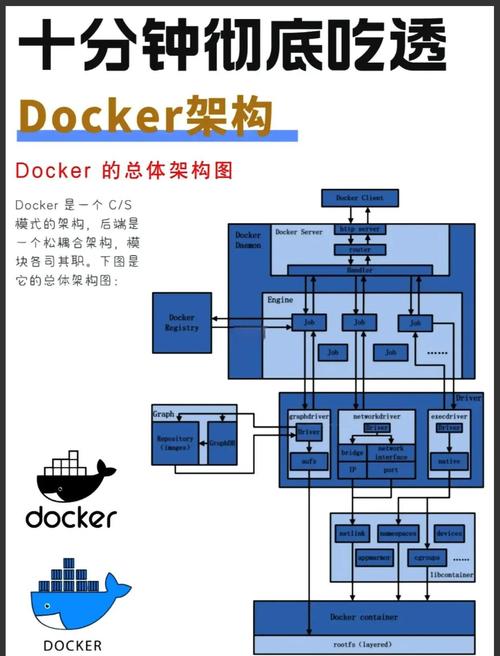
还有胖镜像。我见过一个 Java 服务,基础镜像选了带完整 JDK 的版本,加上各种调试工具、字体库,镜像快两个 G。每次扩缩容,节点拉镜像拉半天。后来换成精简基础镜像,只装运行时的 JRE,体积砍到十分之一。启动速度肉眼可见地变了。
这不是什么高深优化。就是选镜像的时候多问一句:我真的需要这个吗。
镜像还带来一个更微妙的变化——构建这件事从“在机器上装”变成了“写一个可重复的配方”。好处显而易见,环境一致性终于有了点保障。代价是,构建过程本身变成了一门需要打理的技能。缓存失效、层级顺序、依赖锁定,全是新问题。你以为你摆脱了“在我机器上能跑”,其实只是把这个问题往前挪了一层。
编排器让机器变成了抽象
Kubernetes 出现之后,容器化才算真正进入了大多数团队。没有编排,容器就是个进程包装器;有了编排,它变成了一种调度单位。
这带来一个根本性的转变:你不再关心服务跑在哪台机器上。调度器决定。机器是资源池。听起来很美。
但抽象是有代价的。出问题的时候,你得在两层之间来回跳。Pod 起不来,可能是镜像拉取失败,可能是资源不足,可能是调度约束不满足,可能是节点本身有问题。排查路径变长了。以前 ssh 上机器,看日志,重启,完事。现在你得先找对节点,再进对容器,再看对日志流。

说实话,这套东西学起来不轻松。但一旦跑顺了,收益也是真的。滚动更新、自动扩缩、故障自愈,这些能力以前要靠一堆脚本和人工值守拼出来。现在有了一套相对统一的模型。
问题在于,很多人把编排器当成了万能药。什么服务都往里塞,包括那些根本不适合容器化的东西。有状态数据库、需要特定内核模块的应用、对 IO 延迟极度敏感的工作负载——这些进去之后,运维复杂度不降反升。你花了大力气搭了一套编排平台,结果一半的精力用在跟它对抗上。
麻烦只是换了个地方待着
回到开头那个运维团队。他们后来确实把服务都容器化了。机器干净了,配置进了代码,发布流程规范了。但我再见到那个负责人的时候,他跟我说了句:现在出问题更难查了。
不是说容器化不好。是它把复杂度从“机器差异”转移到了“抽象层之间的交互”。以前你面对的是几台配置略有不同的服务器。现在你面对的是镜像、网络插件、存储驱动、调度策略、服务网格——每一层都有自己的行为模式和失败方式。
这事没有银弹。容器化是一套强大的工具,但它不会替你做判断。哪些东西该容器化,哪些不该;镜像该多薄,编排该多深;可观测性该做到什么粒度——这些问题的答案,取决于你的团队、你的业务、你的容忍度。
工具在变,麻烦也在变。唯一不变的是,你得知道自己在干什么。