凌晨两点半,发布窗口还剩四十分钟。群里安静得有点诡异。运维在等测试签字,测试在等开发给回滚预案,开发在等产品确认这个需求到底还要不要上。三个人都熬着,三件事都没错,发布最后还是黄了。
这种夜晚我听过太多次。诡异的地方在于,这些团队不是没做DevOps。CI流水线三分钟跑完,容器编排玩得比谁都熟,监控大屏挂了一整面墙。工具一样不缺,人还是被同一个坎绊倒。
流水线跑得比人快 决策还在原地打转
先讲个反常识的观察。很多团队的部署频率上去了,故障恢复时间却没怎么降。为什么。因为发布这件事被拆成了两段:机器那段自动化了,人那段没有。
代码合并、镜像构建、灰度放量,这些都有脚本兜着。可一旦线上报警,谁有权拍板回滚?回滚到哪个版本?数据库迁移怎么办?这些问题在事故当晚没人答得上来。于是所有人停下手,开始开会。
自动化的边界,其实就是组织授权能力的边界。你流水线写得再漂亮,只要回滚还需要三个人点头,那它就不是一条完整的链路。
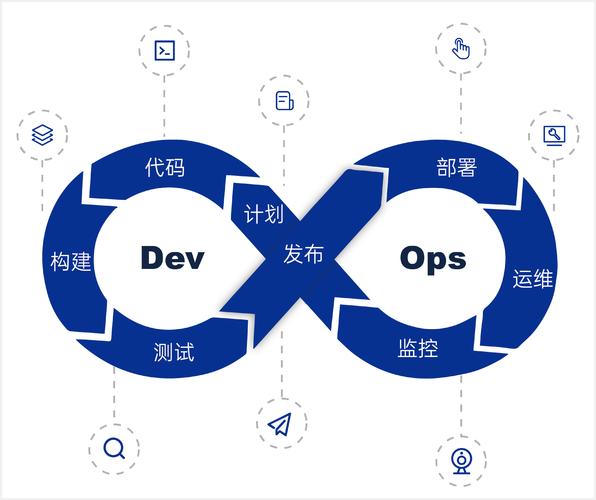
我见过一个挺典型的场景。某团队花了大半年做发布自动化,成功率从六成做到九成五。听起来不错吧。可值班的同学告诉我,剩下那百分之五,处理时间比从前更长了——因为前面太顺,大家已经忘了手工流程长什么样,出事的时候反而更慌。
这算不算退步?不好说。但它至少说明一件事:把人从重复劳动里解放出来,不等于把人从判断里解放出来。判断力这种东西,不练是会退化的。
度量一旦变成考核 数字就开始说谎

DORA那套指标,部署频率、变更前置时间、变更失败率、恢复时长,本身没问题。问题出在它被拿去当KPI的那一刻。
麻烦在于,这四个指标里有两个特别容易被“优化”。变更失败率?把大变更拆成一堆小提交,失败的那次单独回滚,不计入。恢复时长?改改告警口径,从“用户可感知”改成“服务端报错”,数字立刻好看很多。
不是我阴谋论。这是我翻过的一堆季度复盘材料里真实存在的东西。数字是最诚实的,也是最容易被驯服的。
度量指标的正确用法是提问,不是评分。看到前置时间变长,该问的是“哪个环节堵了”,而不是“谁的绩效要扣分”。这两句话看起来只差几个字,团队的应对方式差出十万八千里。
说实话,我甚至建议刚开始做DevOps的团队,前半年别把指标写进考核。让它先裸奔一阵子,看看真实分布长什么样。等大家习惯了被数据盯着看而不紧张,再谈别的。
平台工程不是银弹 它只是把复杂度换了个地方
这几年平台工程火起来,逻辑很顺:开发不该管K8s那些破事,给他们一个自助平台,点两下就能上线。听起来很美。
现实是,复杂度不会消失,只会转移。以前开发自己写YAML,现在他们要学会平台那套自定义的抽象层。抽象层一旦有bug,或者文档跟不上,开发连从哪查起都不知道——因为底下被盖住了。

我采访过一个平台团队,他们做得其实挺克制。只封了最常用的几条路径,剩下的留口子让开发自己下去。负责人跟我说了句话,我记到现在:“我们的目标不是让开发看不见K8s,而是让他们在需要的时候看得见。”
这话挺关键的。好的平台是电梯,不是黑箱。电梯坏了你能走楼梯,黑箱坏了他只能等你修。
真正的分界线 不在工具清单上

写到这里我想绕回开头那个凌晨。那三拨人其实都不缺技能,缺的是对同一件事的共同理解:这次发布,成功的标准是什么,失败的代价谁来担。
DevOps这个词被讲了十几年,工具换了好几轮,从Jenkins到GitLab CI,从虚拟机到容器,从自建到云托管。可每次卡住团队的东西几乎没变过——权责不清、反馈太慢,以及对“稳定”和“速度”这两个词的不同定义。
有一次我问一位做了十年SRE的人,你们团队做DevOps最大的转折点是什么。我以为他会说什么技术选型。他说,是某天老板终于同意“发布失败不算事故,只要能在十五分钟内退回来”。
就这一句话。之前所有准备都到位了,就等这句授权。
所以,如果你正在推DevOps,推得很累,推不动,也许可以先别急着换工具。找个下午,把发布、回滚、告警响应这几件事的决策链条画出来。看看每个节点上是谁在等谁。
通常看完那张图,你会发现,问题根本不在流水线上。
它在你从来没画出来的那张组织图上。