凌晨两点十七分,告警群又炸了。
CPU 打到 92%,P99 延迟翻了三倍。三个人同时被叫醒,打开的却是三个不同的看板——A 同学盯着 Prometheus,B 同学在 Kibana 里翻日志,C 同学翻上一版的发布记录。四十分钟后,有人冒了一句:咦,好像自己好了。
这场景你熟悉吗。我见过太多次。大多数团队不缺数据,缺的是把数据串起来的那根线。
监控回答已知问题 可观测性回答没想到的问题
这两个词被混用得太久了,混到很多采购单上都写着可观测性,装的东西还是十年前那套。
区别在哪?监控是你预先想到了一个故障模式,然后配一条规则去盯它。磁盘写满、进程挂掉、QPS 归零。这些都很有效,而且成本极低。可现实里的故障往往长这样:某个城市的用户下单成功率掉了 3%,原因是第三方支付 SDK 在特定运营商的网络下握手超时。
这东西你没法提前配告警。你只能事后去查。而能不能查出来,取决于你当初留了多少线索。
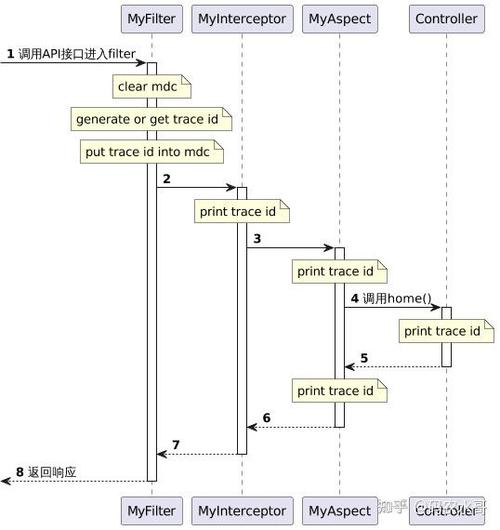
这就是可观测性——它不是一套工具,是一种让你在没有预设假设的情况下,仍然能问出问题的能力。Metrics、Logs、Traces 被叫作三大支柱,说得对,但说得太客气了。真正决定你能不能破案的,是三者之间能不能对上号。一次慢请求,trace 上标了哪一段耗时最长,日志里能不能顺着同一个 trace_id 把当时的入参捞出来,指标上那一分钟的实例是不是刚好在扩容。串不起来,三根柱子就是三座孤岛。
三个花钱最多但收益最差的动作
第一是采全量日志。很多团队上线第一天就把 debug 级别全量打到日志平台,一周之后存储账单让人沉默。采样该怎么做?按错误和慢请求优先,把 tail-based sampling 打开,正常流量留百分之一就足够破案了。
第二是按服务器维度做看板。CPU、内存、磁盘 IO,一屏二十个格子,看着很专业。但业务出问题的时候没人看这些。看板应该按用户旅程来切——下单、支付、发货、通知,每个环节的成功率和耗时。老板问起来,你能直接指着一行说,这儿掉了。
第三是告警越多越安全。这条最要命。一个团队如果每天收到两百条告警,那这两百条都会被忽略。告警疲劳不是态度问题,是生理问题。没人看的告警等于没有告警,还顺带消耗了团队的信任额度。
如果明天就要动手 从哪开始

别急着铺 agent,也别急着选厂商。先用半天时间,把核心链路里最重要的两三个动作写下来,给它们定义 SLI。比如支付成功率、下单 P95 延迟。就这么几个数,别贪多。
然后统一埋点规范。这件事很小,但拖得越久越贵。同一个字段,一个服务叫 uid,另一个叫 userId,第三个叫 user_id——半年后你在日志平台上做 join 的时候会想哭。trace_id 必须贯穿全链路,日志里没有它,等于白打。
成本控制排在第三位,但一定要有人管。指标降采样、日志冷热分离、trace 分层存储,这些都不是什么高深技术,只是没人负责就没人做。
最后是人的部分,也最容易被忽略。值班表、runbook、复盘。复盘的时候只问系统哪里可以改,别问谁手抖了。这不是温情,这是为了让下次故障时,同事愿意第一时间在群里开口,而不是先想着怎么甩锅。
几句不太好听的实话
可观测性不是万能的。五个人的小团队,别上来就自建一套,云厂商托管能省下你三个月的命。也别把它做成 KPI,一旦挂上考核,所有人都会去刷指标接入数量,而没人关心查询是不是真的变快了。
还有一点。工具再好,也救不了一个不愿意在凌晨三点打开看板翻日志的人。技术问题最后常常落在组织问题上,这话听着像鸡汤,可我在三个团队里都见过它的反面案例。
下次告警响的时候,试着先问一句:我们手上的信息,够不够把这件事查到根上?如果答案是不知道,那你的可观测性建设,可能才刚刚开始。