凌晨两点,值班手机响了。某个命名空间下的 Pod 一直 ContainerCreating。kubectl describe 翻到最下面,Events 里一行字:failed to mount volume。存储团队说后端没问题,网络团队说 CSI 插件正常。最后发现是 kubelet 和 CSI 驱动之间的 gRPC 调用超时,默认 15 秒。改了个参数,好了。
这种故事在 Kubernetes 里不罕见。它把很多原本由人肉运维处理的破事,变成了 API 对象和控制器逻辑。但复杂度没有消失,只是换了地方。从“某台机器上服务挂了”变成“某个控制器没有达到期望状态”。
控制平面不是魔法 它是一堆会过期的租约
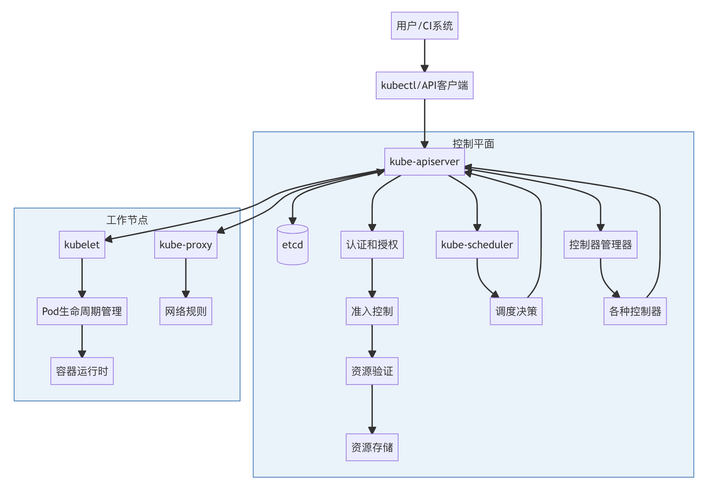
很多人第一次接触 Kubernetes,会觉得 apiserver 是真理。所有东西都往里面塞,YAML 一 apply,世界就该按你说的转。但 apiserver 只是入口。后面站着 etcd、scheduler、controller manager、cloud controller manager。每个组件都有自己的故障模式。
etcd 最容易被忽略。它怕磁盘 IO 抖动,怕网络分区,怕大 key。有人把几千个 ConfigMap 塞进一个命名空间,每个几百 KB,然后 apiserver 的 watch 缓存直接爆。你看到的是 kubectl 卡住,实际是 etcd 的 mvcc 版本涨得太快。压缩没跟上,数据库膨胀到几个 GB。麻烦在于,这事不会立刻报警。它像慢性病,等到 apiserver 开始 504,已经晚了。
调度器也不是全知全能。它只看节点上报的 allocatable,不看实际用量。你给 Pod 写了 request 200m CPU,节点上跑了 50 个这样的 Pod,加起来 10 核,节点只有 8 核。调度器会认为放不下。可那些 Pod 实际 CPU 使用率可能只有 2%。资源碎片就这么来的。有人用 VPA 调 request,有人干脆把 request 设得很低,然后靠 limit 兜底。前者需要重启,后者容易 OOM。取舍很烦。
网络和存储 抽象层下面全是手工活
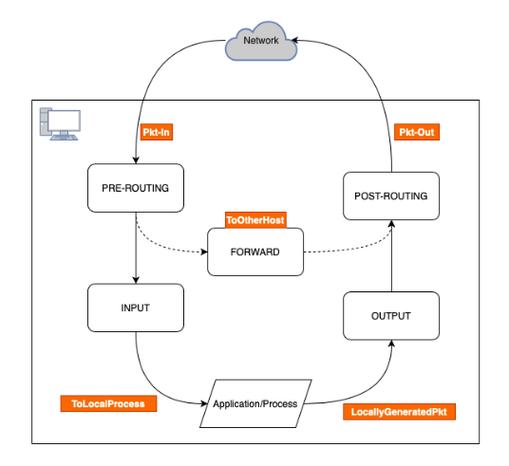
Service 看起来很简单。一个 ClusterIP,kube-proxy 在每台机器上写 iptables 或 IPVS 规则。但规则一多,延迟就上来了。五千个 Service,iptables 链的长度能让你怀疑人生。IPVS 好一些,可它也不是没有状态同步的开销。更别说 NetworkPolicy,如果 CNI 插件实现得不够细,你写的策略可能只生效了一半。
Overlay 网络更微妙。VXLAN 封装解封装,MTU 得跟着调。默认 1500 的物理网卡,Overlay 之后你得设 1450 或者更低。有人没改,小包没事,大包直接黑洞。ping 能通,curl 大文件就挂。这种问题最难查,因为 TCP 握手成功,然后卡在传输。你得用 tcpdump 抓包,看是不是分片丢了。
存储这边,CSI 把供应商的插件标准化了。但标准化的只是接口,不是行为。同样一个 ReadWriteOnce 的 PVC,在云盘上可能几秒挂载,在 NFS 上可能几十秒,在 Ceph RBD 上又可能因为 map 操作卡住。Pod 的启动时间被存储拖累,然后 readiness probe 超时,然后滚动更新卡住。你以为是应用问题,其实是 CSI driver 的 attacher 在重试。
YAML 工程师的诞生 与声明式 API 的代价
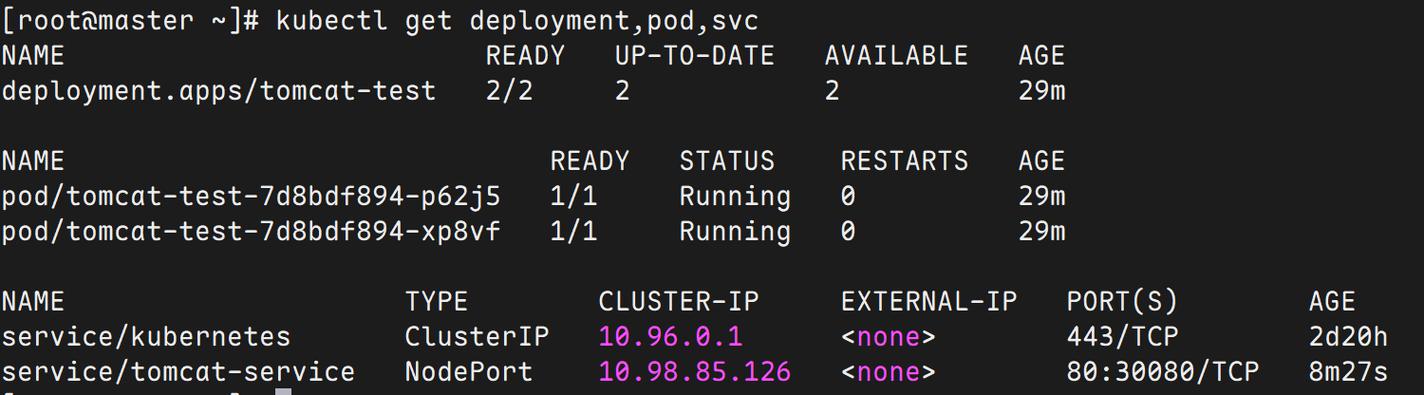
Kubernetes 最成功的设计是 声明式 API。你告诉它想要什么,它自己想办法。控制器不断地调谐,直到实际状态等于期望状态。这个模型很优雅。代价是,你得学会用 YAML 表达你想要什么。而且 YAML 的缩进、类型、默认值,处处是坑。
一个布尔值不加引号,可能被解析成字符串。一个整数被写成 1.0,apiserver 可能拒绝。Helm 模板里套 Kustomize,再加一层 Argo CD 的 sync wave,最后没人知道线上跑的到底是什么版本。GitOps 说是单一事实来源,可如果 CI 里生成 YAML 的脚本没锁版本,那事实来源每天都在变。
Operators 把领域知识写进代码。好处是自动化,坏处是调试变难。一个 PostgreSQL Operator 管理备份、故障转移、版本升级。它挂了,你的数据库集群可能没事,但你不敢动。因为 CRD 的状态字段里藏着一堆条件,只有写 Operator 的人看得懂。升级 Operator 版本,还得看它是否支持从旧 CRD 迁移。这不是运维,这是软件供应链。
我见过最离谱的,是一个团队把整个环境塞进一个 Helm chart,三千行 values.yaml。每次改配置都像拆炸弹。后来他们拆成多个 chart,用 umbrella chart 组装。问题没消失,只是从一个大文件变成了十几个小文件之间的依赖关系。
升级 成本 以及那些没人告诉你的默认值

Kubernetes 的版本升级是另一道坎。每三个月一个 minor 版本,社区支持周期大概一年。你不可能一直不升。但升级前得看 API 弃用列表。1.22 干掉了一批 extensions/v1beta1,1.24 移除了 dockershim,1.25 清理了 PodSecurityPolicy。每一次都有人被卡住。
dockershim 那次尤其典型。很多集群的容器运行时还是 Docker,kubelet 通过 dockershim 调用它。社区把 dockershim 拿掉之后,你得换成 containerd 或者 CRI-O。换运行时本身不难,难的是镜像仓库的认证配置、cgroup driver 的差异、还有那些依赖 Docker API 的脚本。你以为只是换个 runtime,实际是换了一套工具链。
成本也是个慢性问题。Kubernetes 本身不贵,贵的是为了高可用而多出来的节点。request 设置得保守,节点利用率就低。HPA 基于 CPU 扩缩容,但有些应用是 IO 密集或者内存密集,CPU 上不去,副本数就不动。Cluster Autoscaler 要配合节点池的标签和污点,否则扩出来的节点可能调度不上。最后你发现,省钱的唯一办法是让开发团队认真写 request,可他们只关心业务上线。
还有那些默认值。kubelet 的 –node-status-update-frequency 默认 10 秒,controller manager 的 –node-monitor-grace-period 默认 40 秒。节点真挂了,Pod 漂移可能要等一分钟以上。对无状态服务还行,对有状态服务就是灾难。你得调,但调完又要考虑 apiserver 的压力。每个参数背后都是一串取舍。
它不是银弹 但它确实改变了运维的边界
说了这么多坑,不是要否定 Kubernetes。它确实把很多重复劳动自动化了。滚动更新、服务发现、配置管理、密钥挂载,这些事在传统运维里要写一堆脚本和文档。现在你写 YAML,控制器帮你干活。问题在于,YAML 不是免费的。它把运维的边界往前推了,推到了开发者和平台团队面前。
以前运维管机器,现在管集群。以前查进程,现在查事件。以前改配置文件,现在改 CRD。技能栈变了,但排障的本质没变:看日志、看指标、看链路。Kubernetes 只是把现场从一台机器搬到了一个分布式系统里。
如果你正在准备上 Kubernetes,先问自己几个问题。团队里有人懂 etcd 的备份恢复吗?网络插件选型时考虑过 MTU 和 NetworkPolicy 吗?存储的 CSI 驱动有没有在生产环境验证过故障切换?升级路径有没有演练过?这些问题没有标准答案,但不想清楚,Kubernetes 就会变成一个昂贵的 YAML 生成器。
最后一句。Kubernetes 是个好东西。但别把它当宗教。它只是工具。工具会坏,会过时,会有替代品。保持怀疑,保持动手。就这样。