前阵子去一家做本地生活的公司聊架构。会议室白板上还留着 Lambda 的影子。离线 T+1 报表很稳,运营却盯着大屏问:现在这个点,新街口商圈的单量是不是掉了?他们上了实时计算。数字跳得挺欢。可没人敢拍板。
为啥?口径对不上。离线算出来 10 万 3 千,实时大屏 10 万 1 千。差两百。这两百去哪儿了?没人说得清。运营看一眼就关了。实时计算最尴尬的地方就在这儿:它不是把批处理跑快一点,而是换了一套账本。
实时计算不是快一点而是换了一套账本
批处理里,数据是一块一块的。昨天的日志,今天跑。时间边界很清楚。实时计算里,时间是个麻烦。事件时间、处理时间、水位线,这几个词听着技术,落到业务就是:用户十分钟前下的单,现在才上报,你算今天还是算刚才?
水位线设短了,延迟低,但迟到数据容易丢。设长了,结果准,大屏慢半拍。运营要的是“现在”,财务要的是“准确”。这俩经常打架。
还有状态。去重、窗口、join,都得把中间结果存着。状态小,跑得飞起。状态一大,checkpoint 开始拖后腿。作业重启一次,十分钟起步。线上故障可不挑你状态大小。
Exactly-once 也别只听词。端到端要看 source 和 sink。Kafka 能回放,不代表下游数据库能幂等。两边不配合,该重还是重。说实话,很多团队第一次做实时,就栽在这个“端到端”上。
业务敢用的前提是口径能对账
我见过比较靠谱的做法,不是先追低延迟,而是先做对账。实时结果写一张旁路表。离线结果也写一张。按小时、按维度比。误差超过阈值就告警。连续一周稳定,再让业务切过去。
这叫影子模式。笨。但有效。
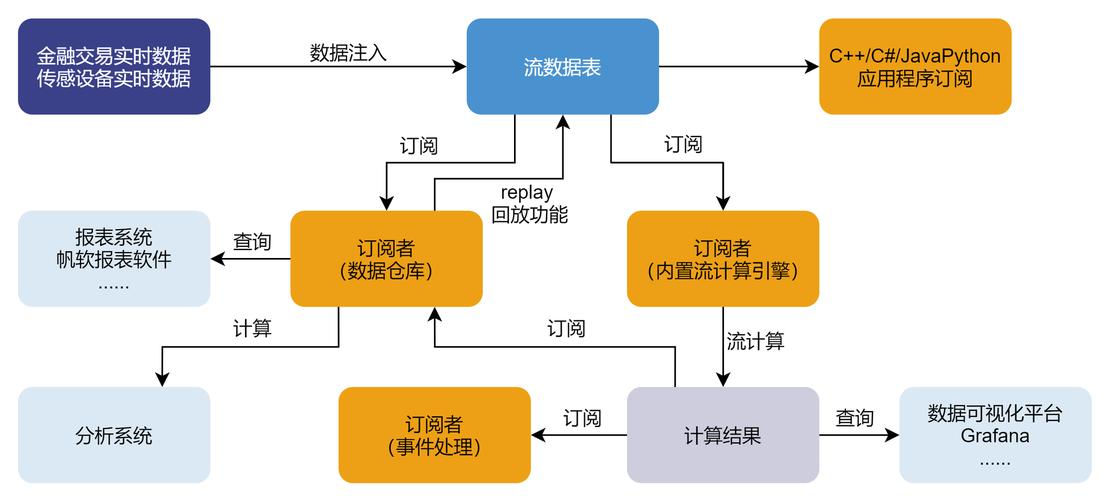
指标定义也得收口。别让每个 Flink 作业自己写 SQL。曝光去重、支付成功、退款扣减,这些口径要沉淀到指标平台。批流共用一份逻辑。做不到完全共用,至少文档写清楚。比如“支付成功”是按支付完成时间还是创建时间?退款算不算?拆单怎么算?
这些问题不解决,实时计算跑得再快,也只是把错误答案提前送到老板面前。对吧。
从一条窄链路开始别铺大摊子
选场景有讲究。高频、痛点明确、容错相对高。风控反欺诈就很合适。物流轨迹异常也行。营销大屏?可以,但别拿它当核心交易账。
库存扣减、优惠券核销这种,链路短、一致性要求高。做得好是本事,做不好就是事故。别一上来全站实时化。团队有没有能值夜班调 checkpoint 的人?Kafka 谁管?监控告警配了吗?这些比选 Flink 还是 Spark 更重要。
行动上,我会先卡这几件事:
- 把指标口径写成能执行的 SQL 片段,不是 PPT。
- 搭最小链路,source 到 sink,先跑通,再谈性能。
- checkpoint 必须开,状态 TTL 必须设。别等磁盘爆了才想起来。
- 对账看板放在业务能看到的地方。不是给技术自嗨。
- 压测和故障演练至少各来一轮。作业重启,数据不丢不重,才算及格。
- 降级预案写清楚。实时挂了,业务能不能退回 T+1?
成本也别装看不见。状态存储、网络跨可用区、ClickHouse 的机器,都是钱。实时计算省的是决策时间,不是 IT 预算。这个账要提前算。
说回那家公司。他们后来没继续堆引擎。先把支付成功和订单量的口径对齐,跑了三周影子模式。误差从几百降到个位数。然后才切了一条营销预警链路。大屏还在,但运营开始拿它打电话了。
实时计算真正难的不是写算子,是让业务敢用。大屏越亮,责任越重。先把账本对齐,再谈速度。不然,跳动的数字只是另一种噪音。