凌晨两点四十,手机响了。
值班的小李盯着屏幕,订单服务的P99从180毫秒跳到4秒。他没慌,先拉开监控大盘——数据库连接池打满了。再往下点,主库CPU 12%。
诡异。
查了两小时才明白:某个下游接口雪崩式超时,把容器里的Tomcat线程全占死了。数据库根本没事。这事最后拖了六个小时才恢复。原因不复杂——没人敢重启那台机器。上面跑着一个临时脚本,三年前写的,没有文档,唯一的注释来自一位已经离职的同事:别动这个。
你看,高可用这件事,往往不是被流量打垮的。
第一个假想敌是我不知道
很多人第一次做高可用,动作是加机器。两台变四台,四台变八台,Nginx前面再挂一层LVS。感觉很稳。
但你问一句:这台现在挂了,谁会受影响?大概率没人答得上来。
这跟预算没关系。是依赖关系没画清楚。我见过一个电商团队,画了整整一面墙的架构图,后来发现图里少了一条线——所有服务都在调同一个配置中心。配置中心只有单节点。他们管这个叫高可用架构。
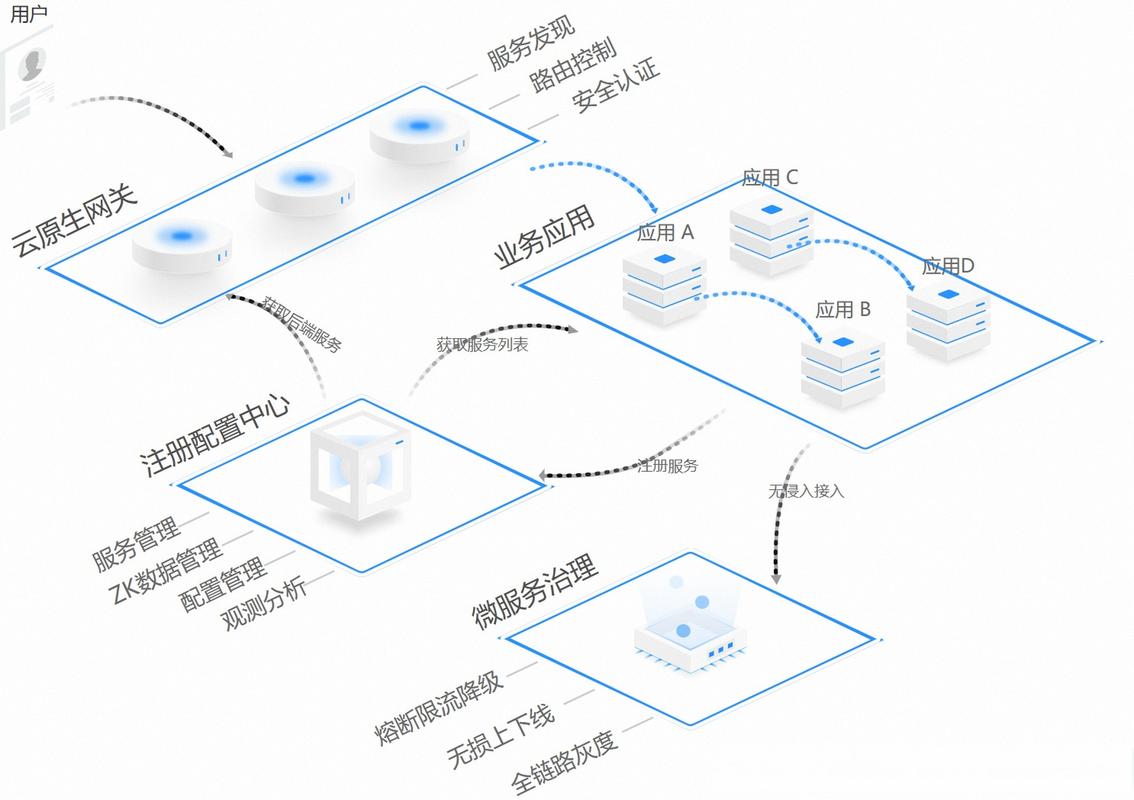
所以我一般建议先干件笨事:把线上所有单点列出来,写在一张纸上,贴显示器边上。数据库主库、Redis主节点、MQ、网关、DNS、证书、那个谁都不敢碰的定时任务。列完你会发现,比想象中多。
冗余是手段 不是答案
双活、多副本、异地多活……这些词听着很爽。可冗余有个非常现实的前提:你的系统得扛得住那个切字。
不少团队做了主从,却从来没做过一次真实的切换演练。真出事的时候手忙脚乱,切过去发现从库延迟两小时,或者切完应用连的还是旧IP。
主从切换的关键,不在于有没有备机,在于切换要多久,切换过程中丢不丢数据,切完了谁去改配置。这三个问题答不上来,备机就只是心理安慰。
说个细节。RTO和RPO这两个词,很多团队写在文档里,但没人真的算过。RTO是恢复要多久,RPO是能容忍丢多少数据。这两个数决定了你到底该做冷备、热备还是双活。不做定量,技术上就全是拍脑袋。
降级开关 是深夜里最值钱的东西
我记得有一次大促,某个推荐服务撑不住了。团队反应很快——直接把推荐模块降级,首页返回默认商品列表。用户看到的东西简陋了点,但下单完全不受影响。整个过程用了90秒。
这就是降级。听起来不高级,但真的救命。
可惜很多团队没这个意识。业务代码一路写下去,推荐调推荐,推荐里面又调画像,画像又调特征平台,链路深得像个黑洞。想降级?不知道从哪儿下刀。
我的建议很土:每个核心链路都要有一个人工开关,能一键关掉非核心依赖。开关放在配置中心,别硬编码在代码里。而且——开关得定期演练。三个月不动的开关,等你真去按的时候,多半是坏的。

混沌工程听着玄 其实就是主动找打

Netflix那套Chaos Monkey,当年看觉得挺酷,现在看其实很朴素——随机杀掉一些实例,看系统还活不活。
你不需要全套工具。从很小的地方开始就行:每周挑一个非高峰时段,随机重启一台生产实例。看监控有没有告警,看流量有没有自动漂移,看有没有异常的报错日志。
第一次做,多半会炸。
炸了就好。在你能控制的时间炸,比在凌晨两点炸强一万倍。
有些团队会担心:生产环境搞这个,出事谁负责?这顾虑合理。所以从小范围开始,做好回滚预案,别一上来就杀主库。这是边界。
说点务实的

高可用架构这词儿被说烂了。落到地上,其实就是几件很具体的事。
把单点列出来,一个个消。演练切换,别只在文档里切。给核心链路配降级开关,并且真的按过。加监控,但别只盯CPU,要盯业务指标——下单成功率、支付成功率、接口超时率。每次出事都写复盘,写清楚根因,别写一句某某操作不当就完事。
还有一条我特别想说:高可用是团队能力,不是架构图的漂亮程度。
你可以抄一份大厂的架构图贴在墙上。但如果没人知道那台机器上跑着什么,没人敢在半夜按下降级开关,那张图就只是一张图。
凌晨两点的电话,迟早还会响。区别在于,那时候你是在翻文档,还是已经知道该点哪个按钮。