凌晨两点十七分,群里有人问了一句:现在回滚还来得及吗。
没人接话。负责的人正盯着大盘,那条错误率的曲线已经平了——不是掉下去的那种平,是贴着天花板躺平。这时候“灰度发布”四个字听起来有点讽刺。明明只放了百分之五。
先把一件事说清楚。灰度发布不是一种发布方式,它是一种**拿可控代价换信息**的做法。你切出去那部分流量,本质上是在买一个答案:新版本扔进真实环境,会不会炸。既然是买,就得算账。买多少样本、看多久、看哪些指标、谁拍板。这四件事有一件是空的,灰度就退化成仪式感——大家一起点个头,然后全量。

“什么叫坏”,大部分团队压根没定义
我采访过不少团队,问他们灰度期间看什么。回答基本是:看监控。
这话等于没说。
得再往下问一层:错误率涨到多少算坏?涨多久算坏?是五分钟内涨一倍,还是十五分钟内持续高出基线百分之二十?如果是延迟,看 P99 还是 P999?如果技术指标全绿,但下单转化掉了百分之三,算不算坏?
这些问题答不上来,灰度就变成了一场漫长的心理安慰。人盯着屏幕看一小时,觉得“好像没事”,然后放量。**“好像”是个危险词。**
比较靠谱的做法是,发布之前把这些阈值写下来,写在发布单里,谁签字谁认。不是走流程,是因为出事的那几分钟,人的判断力非常差。你会本能地找证据说明问题不大,会想“再等等看”“可能只是抖动”。提前定好红线,是为了让当时的你没法骗自己。
还有一个容易被忽略的点:阈值要分两类。一类是技术红线,错误率、超时率、CPU、连接数,触发了就停。另一类是业务红线,支付成功率、搜索无结果率、加购转化,触发了就得停下来讨论。前一类可以自动回滚,后一类只能人来判。混在一起处理,要么误伤,要么漏判。
先别纠结切多少,先看你切得干不干净
“我们灰度比例定多少合适”是个伪问题。真正该先问的是:你按什么维度切。
按用户哈希切,看起来最公平。但这里有个坑——同一个用户必须在同一个版本里。做不到这一点,麻烦就大了。前端资源带 hash 的话,用户在这次请求里加载了老版本 JS,下一次请求被路由到新版本接口,返回的数据结构对不上,页面白屏。用户不会给你报 bug,他直接走了。
所以粘性会话不是个可选项,是前提。用户 ID、设备 ID、租户 ID,你得有一样稳定的东西能哈希,而且前端和网关得用同一套规则。
按地域切呢?运营部门一般很喜欢,因为能对比。代价是地域本身就是个混淆变量。华东的用户就是比西北的活跃,你拿两个地域对比版本差异,很容易把地域差异当成版本差异。样本够大还行,样本不够大,结论基本靠猜。
还有一个更朴素的问题:**你的切流粒度真的生效了吗。**我见过不止一次,网关按权重切了百分之十,但下游某个服务走的是另一套路由,全部打到了新版本上。大盘上看着是灰度,实际上已经是全量。这种事故特别隐蔽,因为所有配置都“对”,只是没人验证过。
验证方法很土但很有用:放量之后,去日志里按版本号 group by 一下,看请求数占比和你以为的比例差多少。对不上,先别往下走。
指标没打版本标签,灰度等于白做
这是我这几年见到最高频、也最容易被事后诸葛亮的一个坑。
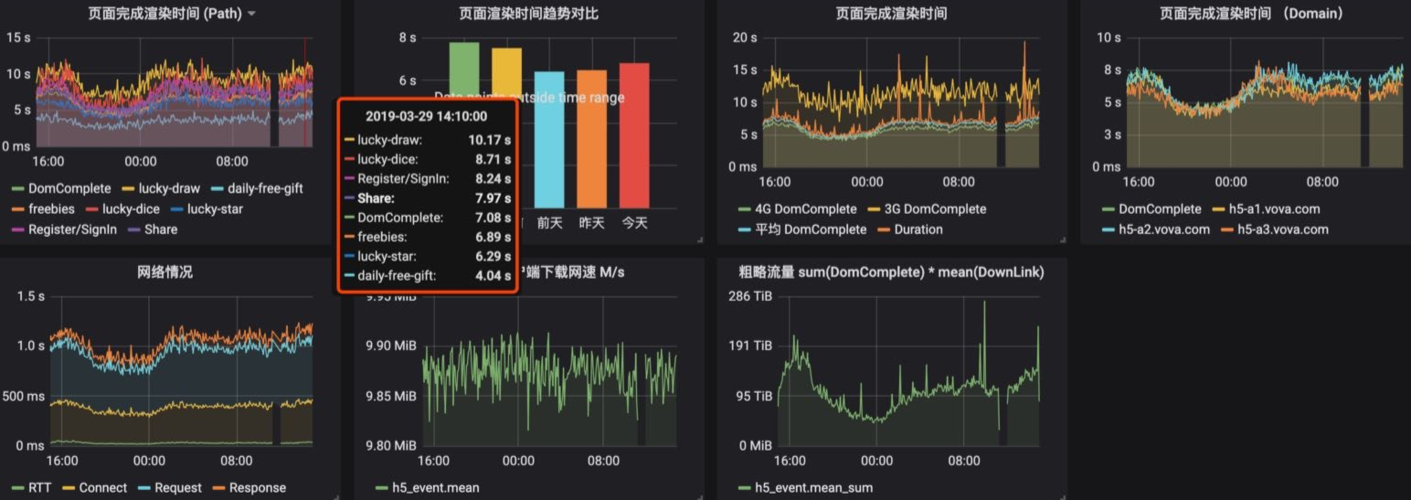
假设你的监控埋点长这样:order_create_success,打点的时候只带了一个服务名。那灰度期间新旧两个版本的数据是混在一起的。你看到的那条曲线是平均之后的曲线。新版本把错误率拉高了一倍,老版本把它摊平了——大盘看起来微微上扬,像正常波动。
**灰度想看到的不是平均值,是差值。**差值只能在指标里带上版本维度才能算出来。
所以埋点要带 tag。version、revision、release-id,叫什么无所谓,关键是要能从监控里按这个维度拆。日志同理,trace 同理。很多人以为这是可观测性团队的事,其实不是——**这是发布流程的前置条件。**没有版本维度的指标,你的灰度就是在盲放。
回滚真正的门槛,不在摁键那一下
聊到回滚,绝大部分人会想到“把镜像 tag 换回去”。
代码能换回去。数据不行。
这是灰度发布里最硬的一块。只要这次变更碰了存储、消息格式、缓存结构,回滚就不再是一个动作,而是一串有顺序的操作,而且可能根本退不回去。
举个不长的例子。有个团队升级订单服务,新版本顺手把 Redis 里缓存 value 的结构从数组改成了对象,多包了一层。灰度期间两个版本共用同一个 key。新版本写进去的数据,老版本反序列化直接抛异常。灰度比例只有百分之三,错误率的绝对增量很小,被几个别的告警淹没了。等到放量到一半,老版本实例全在报反序列化失败。
这就是所谓的不可逆变更。它的问题不在于技术难度,在于它**让灰度失去了兜底能力**——你心里以为“出事就回滚”,但真出事的时候,回滚会把问题变得更大。
业内的通用解法是把这类变更单独拎出来做,拆成几步:先加新结构,新旧共存,双写;再把存量数据回填;然后切读,观察;最后才删旧结构。每一步都是可回滚的,每一步之间都要有观察期。业内叫 expand-contract,名字无所谓,核心就一句话:**让每一小步都是可逆的。**
数据库的加字段能退,改字段类型基本退不了。消息队列这边,消费者灰度期间新老两版同时消费一个 topic,那消息格式必须向后兼容——新字段要有默认值,旧消费者不认识就忽略。做不到的话,别用灰度,用双 topic 更实在。
观察窗口别拍脑袋,要盖住业务的完整周期

“放一小时没事就继续”,这个一小时是怎么来的。
如果业务有日结、有对账、有夜间批量任务,那一小时的观察窗口什么都没盖住。真正的问题可能要到凌晨那个批处理跑起来才暴露——而那时候人已经睡了。
灰度阶梯也是同理。百分之五、百分之二十、百分之五十、百分之百,这个阶梯本身没毛病,问题在于每一档停留多久。停留时间取决于两件事:一是业务周期,二是样本量。
样本量这件事常被忽视。如果你一天只有几百个请求,百分之五就是几十个。这几十个请求里出一次错,和出两次错,统计上说明不了任何问题。这时候你需要的不是看比例,是把灰度比例调高,或者干脆换个验证方式——比如先上内部员工,或者先上一个愿意配合的小客户。
还有一种情况:核心链路的 QPS 很高,百分之一就够了。这时候别贪,慢慢来。**放量快慢是一个风险偏好的选择题,不是技术能力问题。**
最后说个感受。做了几年技术编辑,我发现灰度发布这个题目,讲的是发布,考的其实是两件事:一是你对自己的系统到底了不了解,二是你愿不愿意在出事的时候承认“我错了”。
第二件更难。
因为摁下回滚键,意味着承认过去几个小时的判断是错的,意味着要跟老板解释,意味着版本要重新排期。很多事故不是被放大的,是被拖延的。那几分钟的犹豫,比灰度的比例设置重要得多。