智汇 IT
城启新篇

缓存策略我劝你先别急着上Redis

凌晨两点四十,手机在枕头边上嗡了一声。 我点开钉钉,运维小哥连发三条消息:数据库连接池满了,线上服务全红。那个瞬间我就知道了,又是缓存那点破事。 干这行快八年,最怕的不是需求变更,是缓存出问题。需求变了改代码就行。缓存出问题?那是半夜被叫起来改代码。
运维人员深夜查看Redis缓存服务告警面板

缓存不是用来保护数据库的

缓存不是用来保护数据库的
缓存不是用来保护数据库的
这话听起来有点反直觉对吧。你上Redis,不就是为了给数据库减压吗? 对,但只说对了一半。 缓存真正的价值,是把数据库的读压力转嫁到内存里,让响应快起来。但它的另一面是——一旦缓存层出问题,所有请求会直接穿透到数据库。平时100个请求里95个被缓存接住了,数据库只扛5个。突然缓存全挂了,100个请求全部砸向数据库,它扛得住吗? 扛不住。 这就是为什么缓存雪崩的杀伤力这么大。它不是在原有压力上加了点什么,而是把保护层直接抽掉了。 我见过一个团队,秒杀活动前把所有热点商品塞进缓存,统一设了30分钟过期。零点开抢,三十分钟后,所有key同一秒失效。流量像泄洪一样冲进MySQL,连接数瞬间打满,整个服务链路全红。 修复方案不复杂——过期时间加随机值。基础30分钟,再加个0到300秒的随机偏移。就这一个细节,能把雪崩的概率压得很低。 但没踩过的人,真想不到。 除了雪崩,还有两个经常被混淆的概念:缓存穿透和缓存击穿。 穿透是查一个数据库里压根不存在的数据。缓存没有,数据库也没有,每次请求都要走一遍完整链路。恶意攻击最喜欢用这招,拿一个不存在的id疯狂请求,数据库被打得毫无还手之力。 击穿呢,是某个热点key刚好过期的那一瞬间,大量请求同时涌进来。它跟雪崩的区别是——雪崩是面,击穿是点。但点的杀伤力有时候比面还大。 这些问题说到底,都是对缓存会失效这件事准备不足。很多人潜意识里把缓存当成一个永远在线的保护盾。但缓存是会坏的、会过期的、会被淘汰的。你做缓存策略的第一件事,不是想缓存能帮你省多少事,而是想缓存挂了怎么办。

过期时间到底设多少才不心虚

这个问题我被问过太多次了。 “缓存过期时间设多久合适?” 说实话,没有标准答案。但我有一个判断原则——宁可短一点,别太长。 设短了,最多是缓存命中率低一些,多回几次数据库。设长了,数据不一致的窗口就大,用户看到的可能是半小时前的订单状态。哪个更难受,你自己掂量。 不过短也不是无脑短。如果缓存10秒过期,QPS又高,那跟没缓存差别不大,还多了一次Redis往返。缓存的意义就没了。 我的经验是,先看业务能容忍多久的数据延迟。这个延迟就是过期时间的上限。比如商品详情页,用户能接受5分钟内的价格变动,那过期时间就别超过5分钟。
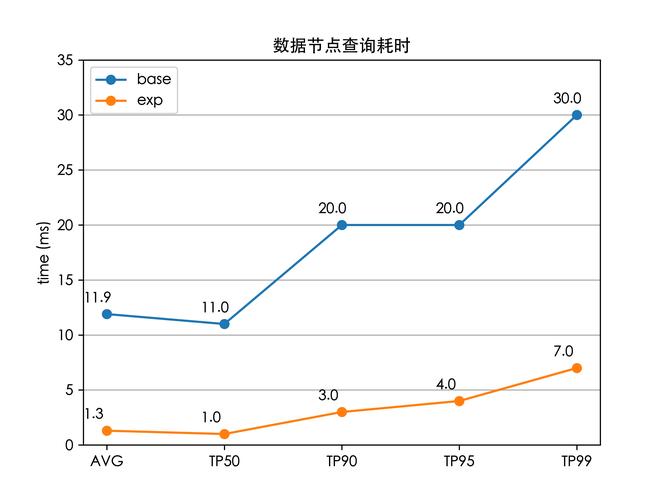
缓存过期时间与数据库回源请求量关系曲线图
还有一个细节——不要给所有key设同样的过期时间。均匀分布的过期时间比整齐划一的要安全得多。这个我前面说过了,但值得再说一遍,因为它真的太容易被忽略。 另外还得考虑缓存淘汰策略。Redis默认是noeviction,内存满了直接报错。你得根据业务场景选LRU或者LFU。LRU适合热点相对稳定的场景,LFU适合热点变化快的场景。选错了,要么频繁淘汰有用的数据,要么一堆冷数据占着内存不走。

一致性这道坎绕不过去

一致性这道坎绕不过去
一致性这道坎绕不过去
缓存和数据库的一致性,是每个做缓存策略的人都得面对的问题。 常见做法是“先更新数据库,再删缓存”。这个方案能覆盖大多数场景,但它不是银弹。 为什么是先删缓存而不是先更新缓存?因为更新缓存的并发场景太复杂了,两个请求同时更新,顺序没法保证,缓存里可能留着脏数据。删掉反而干净,下次读的时候自然会从数据库加载最新的。 即使先更新数据库再删缓存,也存在一个极端的并发窗口。请求A更新了数据库,还没来得及删缓存,请求B读到了旧缓存,然后A删掉了缓存——这时候缓存是空的,没问题。但如果反过来,请求B在A删缓存之后、更新数据库之前读到了旧数据并写回缓存,脏数据就留下来了。 这个窗口极短,大部分业务可以忽略。但如果是金融、库存这类对一致性要求很高的场景,就得考虑延迟双删或者订阅binlog异步刷新缓存。 不过话说回来,不是所有业务都需要强一致。商品描述这种数据,延迟几秒钟更新,用户根本感知不到。为了一个用户感知不到的延迟,去引入复杂的分布式锁或者消息队列,纯属给自己找麻烦。

有些场景真的不该上缓存

有些场景真的不该上缓存
有些场景真的不该上缓存
最后说点得罪人的话。 不是所有业务都值得上缓存。 如果你的QPS本身就很低,数据库完全扛得住,那加一层Redis除了增加运维复杂度,几乎没什么收益。 如果你缓存的数据变化非常频繁,写操作比读操作还多,那缓存命中率会非常低。每次读都miss,每次写都要更新缓存,反而成了负担。 还有一种情况——数据量很小,全量加载到本地内存就够了。这种场景上Redis属于杀鸡用牛刀。一个Caffeine或者Guava Cache就能解决的问题,没必要引入一个独立的外部依赖。 缓存策略的精髓不在于用不用缓存,而在于——在哪一层缓存、缓存什么、缓存多久、失效了怎么办。这四个问题想清楚了,你半夜被叫起来的概率会小很多。 想不清楚的话……那就像我一样,把手机震动调大点声吧。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:缓存策略我劝你先别急着上Redis
文章链接:https://m.itcdj.com/news/950.html