可观测性不是监控的升级版
2026-11-19 12:26:29
作者:
fawen
凌晨两点十七分,手机响了。值班群里一行字:支付成功率掉了三个点。
我的第一反应是……完了,又是谁的告警阈值拍脑袋定的。结果打开面板一看,CPU 正常,内存正常,数据库连接数正常。所有指标都安安静静地绿着,可用户就是付不了钱。
这种时刻,你才明白监控和可观测性的区别。不是说监控没用——是它答不上你真正想问的那个问题:到底哪里不对。
监控回答已知的问题 可观测性回答没想过的问题
传统监控的思路,是先假设故障长什么样,然后给这个假设配一个阈值。磁盘满了、进程挂了、QPS 掉了。这些都是我们事先想得到的。想得到的部分,监控干得挺好。
但线上故障有个特点:它总在你没想到的地方冒出来。
比如一个下游服务超时重试,把上游线程池占满了。比如某个用户 ID 的哈希全都落到同一个分片。再比如某次发版改了一个 JSON 字段名,前端静默降级,谁也没报错。
这些事,事前根本想不到,也就没法配阈值。
可观测性换了个思路。它不预设你会问什么问题,而是把系统运行时产生的原始信号尽量完整地留下来——指标、日志、链路,这三样老生常谈,但真正做对的团队不多。
 微服务链路追踪调用链拓扑图
重点在完整两个字。很多团队的日志只记 INFO 以上,链路只采 1% 的样本,指标只有 60 秒粒度。等到出事那天,你恰好需要的那个字段,恰好没采。这才是最让人抓狂的。
三件容易被忽略的事
先说采样。1% 的链路采样率在流量大的时候挺省钱。可你想过没有——如果出问题的那条路径正好落在被丢掉的 99% 里呢?我的建议是按错误优先采样:正常请求采 1%,报错请求全采。成本增加有限,排查体验天差地别。
再说基数。给指标打标签是好事,但标签组合一旦爆炸,时序数据库能把你的账单撑到离谱。user_id 这种东西永远不要当标签,塞进日志或者 trace 的 attribute 里。这个坑,踩过一次就忘不掉。
还有一个更隐蔽的:上下文传递。用户点了一下按钮,后端可能经过网关、订单、支付、风控四五个服务。没有统一的 trace_id 串起来,你只能在四个日志系统里分别搜,靠时间戳硬对。对得上算你运气好。
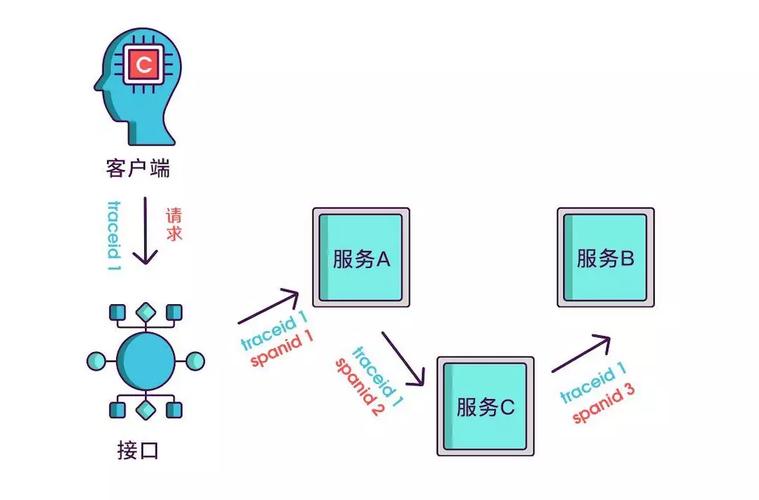 分布式系统请求上下文trace_id传递示意图
别一上来就上全家桶
我见过太多团队,一听说可观测性,立刻采购一套商业 APM,全员培训,三个月后打开率不到 5%。为什么?工具是买来了,但没人回答过一个问题:谁,在什么场景下,会去看它。
我的做法比较土,但管用。
先把日志统一收上去。别管结构化不结构化,先做到能集中搜。这一步能解决六成以上的日常排查。
然后把核心链路的 trace 打通。不用全量,先挑那条最赚钱、最容易出事的业务线。支付、下单、登录,选一个就行。做完之后你会发现自己对系统的理解都变了——原来这个接口背后悄悄调了七个东西。
最后才是指标告警的精修。前面两步做完,你已经知道哪些指标值得告警了。这时候去调阈值,是有依据的,不是拍脑袋。
一个反直觉的结论
 一个反直觉的结论
工具越贵,不等于恢复越快。
真正决定 MTTR 的,往往是两件很人的事:告警有没有指向正确的入口,以及那个被叫醒的人知不知道去哪看。
我见过最有效的一次改进,是在告警消息里直接贴了一条查询链接。点开就是他要的那个面板,不用登录三个系统。改动量?半小时。效果?平均排查时间少了十几分钟。
所以回到那个凌晨两点十七分。后来我们怎么找到问题的?翻日志翻了四十分钟,最后在一个不起眼的 WARN 里看到重试次数在涨。如果有 trace,这事大概五分钟。
可观测性不是买来的,是长出来的。它长在你每次排查之后留下的那条查询语句里,长在每次复盘时补上的那个字段里。工具只是容器,装什么,得靠人往里放。
嗯,就这样。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
可观测性不是监控的升级版
文章链接:https://m.itcdj.com/news/948.html