凌晨两点,值班群里弹出一张截图。某张报表的收入数字比昨天少了一截。分析师说没改SQL,开发说没发版,调度平台显示任务成功。问题卡在这儿:谁动了上游那张维表?
这时候如果血缘图只是几张PPT,团队只能靠人肉翻日志。先找表,再找字段,再找任务,再找发布单。半小时过去,咖啡凉了,锅还没落地。数据治理中的数据血缘追踪,真正要解决的就是这种时刻:不是展示关系,而是缩短定位问题的路径。
先别画大图 先把问题定位路径缩短
很多团队一提血缘,就想搞一张覆盖全公司的宇宙大图。表、字段、指标、报表、任务、应用,全塞进去。看着热闹。真出故障时没人点得动,也没人知道该信哪条线。这事没那么玄。血缘的一层价值是影响分析:改一张表,谁会疼;停一个任务,哪张报表会黑。另一层价值是根因定位:数字不对,往回追到哪个字段、哪段逻辑、哪次变更。
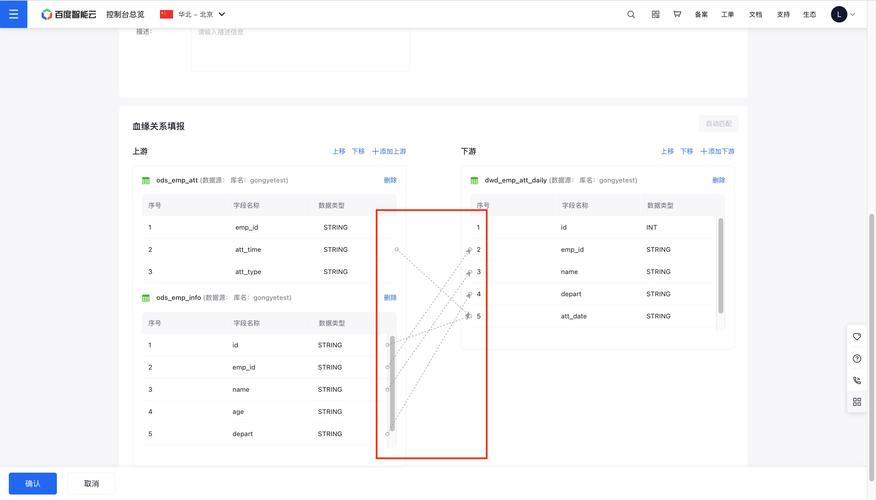
说白了,血缘不是给领导看的拓扑图,是给排障的人走的路径。路径要短,要准,要能落到字段。只到表级,遇到宽表就抓瞎。一张宽表几百个字段,里面混着订单、退款、优惠、渠道。表级血缘告诉你上游表变了,但不知道是哪个字段脏了。分析师只能一层层拆SQL,拆到怀疑人生。
所以建设顺序别反过来。先圈核心链路,比如交易、账务、核心报表。先把这些链路的字段级血缘做扎实。长尾表可以后补。全量覆盖听起来美,成本也美。解析器要适配各种方言,调度要接各种系统,存储过程、Python脚本、Spark、Flink、BI 数据集,哪一样都不省心。
字段级血缘为什么总缺一口气
字段级血缘的麻烦在于,SQL 不是老老实实写在文件里的。动态拼接、临时表、UDF、视图嵌套、宏变量,随便一个都能让静态解析翻车。你解析出来的血缘,可能只覆盖了七成。剩下三成藏在运行日志、查询历史和执行计划里。
只靠静态解析,快,便宜,但容易漏。只靠动态采集,准,但成本高,侵入性强,还得处理海量日志。现实做法通常是混着来:离线 SQL 走解析,Spark、Flink 任务补运行态血缘,BI 层用查询日志反推字段引用。然后用抽样比对去校验。准确率不是喊出来的,是一轮轮对出来的。
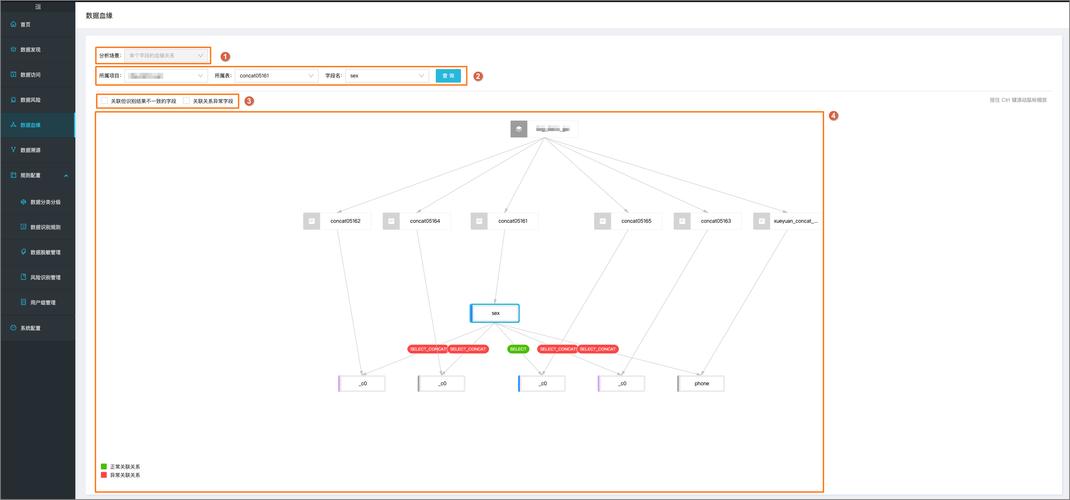
还有一个坑:调度依赖不等于数据依赖。任务A跑完再跑任务B,不代表B真的读了A的输出。调度系统知道先后,不知道字段流向。把调度依赖当血缘,影响分析就会多报、误报。次数多了,没人信。血缘一旦失去信任,后面所有治理动作都推不动。
更烦的是改名和重构。表改名、字段改名、任务迁移、分层调整,血缘边如果只存当前状态,历史链路就断了。今天追一个问题,发现上游表两个月前已经没了,旧血缘指向空气。所以血缘要带时间戳和版本。哪一天、哪个版本、哪次发布,字段怎么流。没有时间维度,血缘只能看当下,不能复盘。
采集和解析的脏活决定成败
血缘系统一般拆成几段:采集元数据,解析关系,合并去重,存储图结构,对外查询,末端才是可视化。最容易被低估的是合并。同一个字段,SQL解析说来自表A,日志说来自临时表T,临时表又来自表B。你得把中间态折叠掉,又不能把真实路径抹掉。这里需要稳定的实体ID。表名会变,字段名会变,实体ID不能变。
存储也有取舍。图数据库查多跳关系顺手,但写入和运维复杂。关系型数据库简单,但深链路查询容易慢。规模不大时,关系型加索引也能撑。规模上来后,再考虑图库或专门的血缘存储。别一上来就堆最重的架构。先跑通,再优化。很多项目死在第一步:平台选型讨论了三个月,一条核心链路都没接。
查询侧要克制。别默认展示全图。用户输入一张表,先给一度二度关系,再按需展开。字段级血缘尤其要能过滤:只看关键字段,只看跨层链路,只看最近变更。否则屏幕上全是线,像一团毛线。排障的人不需要毛线,需要箭头。
别急着买平台 先跑通一条救火链路

我见过一个不算复杂的做法。团队先挑了一张核心报表,把上游任务、SQL、字段映射全部人工核对一遍,再用解析结果去对。对不上的地方,不是直接改解析规则,而是先记录为什么对不上:动态SQL、临时表、还是权限看不到。两周后,他们覆盖了这条链路。后来一次指标异常,从发现到定位到具体字段,用了十几分钟。之前靠人问,大半天就没了。
这个案例不炫。但有效。血缘追踪不是买来的,是一段段接出来的。采购平台可以省事,但省不掉数据源接入、解析适配、口径确认这些脏活。谁家的平台都不能替你搞清业务字段含义。技术血缘告诉你字段从哪来,业务血缘告诉你这个字段代表什么。两条线要能对上,否则查到字段也不知道该找谁。
再提醒一句,血缘不是静态资产。数据在变,任务在变,人在变。血缘系统要有巡检,有告警,有准确率指标。比如解析失败率、孤立节点比例、字段级覆盖率、变更后血缘更新延迟。指标不用多,但要能暴露退化。不然上线那天很漂亮,三个月后全是过期边。
说到底,数据治理中的数据血缘追踪,拼的不是图多好看,是关键时刻能不能指对方向。夜里的报警少一点,排障的人早睡一点。这个目标朴素,也够难。