周日晚上十一点半,手机屏幕亮了。是告警。你没看错——又是那台边缘节点的内存,连续第三天在同一个时间点越过 85%。你翻了个身,把手机扣在床头柜上。没起来。
这不是你第一次忽略它。很可能也不是最后一次。但那一刻你脑子里闪过的念头其实特别具体:要是它真挂了,我明天早上会收到用户投诉。要是没挂,这事儿就过去了。
监控告警这件事最诡异的地方就在这儿——它本应该让你安心,结果却让你变得麻木。
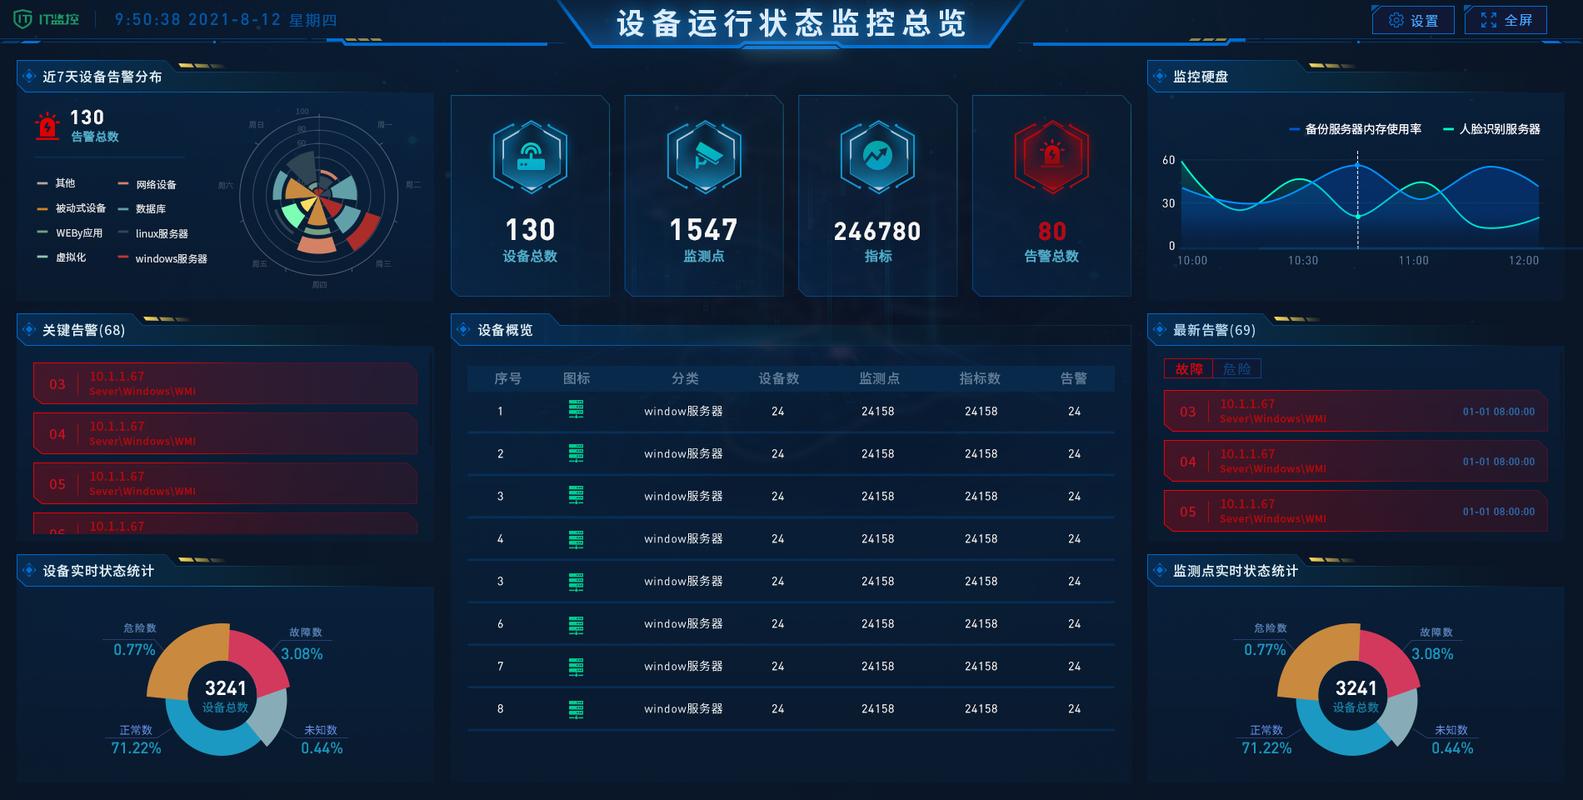
告警疲劳是被喂出来的
我见过一个团队,Prometheus 上跑着两千多条告警规则。负责人挺骄傲地跟我说,覆盖面很全。我问他每天大概响多少次,他说工作日平均三百来条,周末少点。
三百条。你知道这意味着什么吗?意味着这个团队一天的工作时间被切成了三百块碎片。更糟的是,其中至少有两百条是噪音——某个批处理任务短暂的失败重试,或者一次正常的容器重启触发了抖动阈值。
没人能在这种信息密度下保持清醒。当告警变成背景噪音,真正的故障就会被淹没。这不是人的问题,是设计的问题。
后来他们把规则砍到了四十七条。对,砍掉了 97% 还多。真正需要立刻干预的其实就那么几类:核心接口错误率飙升、数据库连接池接近耗尽、主从延迟漂移到危险水位。其他的呢?全改成了日报或者仪表盘上的一个图。
阈值为什么是个陷阱
大部分团队的告警规则都是一个模式:某指标超过某个数,就报警。简单粗暴。但问题是,固定阈值完全无视了系统行为随时间的变化。
你那个边缘节点白天内存跑到 70% 很正常,晚上降到 30%。结果你把阈值设成 60%。晚上它稍微多缓存一点日志,就炸了。而白天忙得要死的时候,反而安安静静。
这不是阈值的问题,是你没有把时间和业务节奏放进去。现在很多工具已经支持动态基线了,比如基于过去一周同时段的数据算出一个合理的波动区间。听起来高级,其实思路特朴素:你总得知道自己平时长什么样,才知道什么时候不对劲。
还有个更隐蔽的坑:很多告警只关注瞬时值,不管持续时间。一个瞬间的尖刺和持续十分钟的高位是完全不同的两回事。加一个 for: 5m 就能过滤掉大量抖动,代价只是延迟五分钟发现——但说实话,真正紧急的故障,五分钟根本不影响你救火。

谁该起来,起来之后干什么
告警发出去不是终点。它只是一声喊。真正决定成败的是:谁被喊醒,以及他醒来之后的第一件事做什么。
我见过最离谱的配置:所有告警都发到同一个群。前端、后端、运维、DBA 全在里面。一旦某个服务挂了,所有人手机一起响。那种场面跟防空演习似的。问题是,前端同学根本不知道 MySQL 主从延迟该怎么处理。
好的做法其实不复杂:
给每条告警打上责任域的标签。然后路由到对应的人。升级策略也得有——十五分钟没人认领,再通知上一级。别搞什么全员广播,那是偷懒。
还有一点经常被忽略:告警消息里必须包含足够上下文。别只写“CPU 过高”。要写清楚是哪个机房、哪台机器、什么服务、当前值多少、持续了多久、相关的仪表盘链接在哪儿。让被叫醒的人三十秒内进入状态,而不是花五分钟手动登录查来查去。
从删告警开始
如果你现在正被告警淹没,别想着加规则了。反过来做:打开过去两周的告警记录,按频率排个序。排在前面的那些,挨个问自己——这条告警触发的时候,我真的需要立刻行动吗?
如果答案是不需要,就删掉,或者降级为通知。
听起来简单。但你试试跟你团队的人解释,为什么把一条“看起来很重要”的告警拿掉。会有人反对的。他们会说万一呢?万一那个情况真的发生了怎么办?
是啊,万一。但那个万一的代价,是一年来每一天都在被噪音折磨。这笔账其实不难算。
监控告警的本质不是覆盖所有可能性。是在正确的时间,把正确的人,叫到正确的地方。其他的一切,都是噪音。
删掉几条规则,今晚你会睡得更好。真的。