灾备演练这四个字,写在合规材料里很安静。真进机房,它一点都不安静。风扇声、电话声、有人喊先别切。有人盯着监控不出声。最怕的不是报错,是没人敢按那个确认键。
我跟着做过几次演练。有半夜的,有周末的。也有那种早上九点开始,业务方一边切一边接客服电话的。场面很魔幻。说白了,灾备演练不是验证设备有多贵,是验证组织在压力下会不会散。
凌晨两点的切换窗口
很多团队把窗口放在凌晨两点。理由简单,交易少。麻烦在于,人也是最低功耗状态。DBA 刚被电话叫醒,网络工程师在找 VPN 令牌,系统管理员翻变更单。每个人都说自己这块没问题。合在一起,问题就来了。
切换前要看的从来不只是复制状态。RTO 和 RPO 是纸面目标,现场先卡权限、流程和依赖关系。复制延迟多少,日志序列号差多少,队列积压有没有消化完,连接池里还有没有旧会话。这些东西,监控大盘上不一定全有。有也不一定放在同一屏。
DNS 切换最容易被低估。TTL 改了吗?改多久了?应用是连域名还是写死 IP?负载均衡后端健康检查配了吗?这些问题平时没人问。演练时一问,会议室就安静。然后有人小声说,这个服务是三年前外包做的。得,开始翻文档。
还有数据库。主从切换不是按个按钮。切换前要不要锁写?应用要不要停?中间件连接池要不要重启?只读副本的延迟会不会把旧数据带回来?如果存储层做了双活,还要防脑裂。脑裂这个词听着玄,真发生时就是两边都觉得自己是主。

演练剧本越漂亮 现场越容易露馅
很多演练方案写得像电影脚本。第几分钟做什么,谁执行,谁验证,谁汇报。格式很漂亮。问题在于,真实故障不照脚本走。
有次我旁听一个团队复盘。他们切换很顺。五分钟内应用起来了,登录也正常。业务方一开始说通过。后来财务同事试了一下,报表跑不出来。再查,消息队列消费者没启动。订单数据在队列里堆着,页面看不出来。后来他们加了一条验证:不是看进程在不在,是下一笔真实业务单,看整条链路能不能走通。
这事不大,但很典型。业务方认不认,比技术指标好不好看更重要。运维说恢复了,业务说不能用,那就是没恢复。演练不是给自己发奖状。是提前把难堪找出来。
还有配置漂移。测试环境跑通的脚本,到生产就报错。因为生产多了一个安全策略,少了一个环境变量,或者证书过期了没人发现。备份也是。备份成功不代表能恢复。恢复成功不代表完整。恢复完整不代表业务能起来。备份、恢复、切换、回切,是四件事。少练一件,真出事就得多熬一夜。
别把回切当成收尾 它才是账单
很多演练只练切过去。切完,大家松口气,写报告,下班。回切呢?排到下周,或者下个月。然后就没人提了。
麻烦在于,回切往往比切换更难。切换时主侧还在,数据有源。回切时,备侧已经跑了几个小时,产生了新数据。反向同步能不能追上?增量日志有没有断?主侧原来的数据要不要清?如果直接切回,丢的那部分谁认?
我见过一次演练,切换花了四十分钟,回切花了三个小时。不是技术多复杂。是没人拍板什么时候可以回。业务说再等等,运维说现在窗口好,网络说链路要重新收敛。每个人都在等别人先点头。时间就这么过去。
回切也要有演练窗口,也要有验证清单,也要有决策人。不然真故障时,团队只熟悉前半场。后半场靠临场发挥。临场发挥这件事,平时是故事,关键时刻是事故。
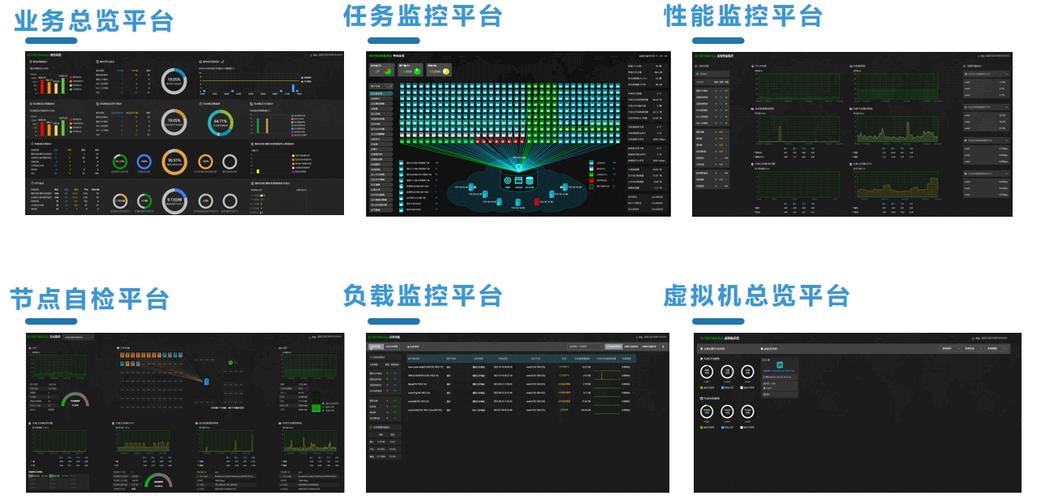
演练报告别写成庆功稿
演练结束,最没用的报告是“总体顺利,达到预期”。什么叫达到预期?预期是什么?谁定的?这些问题不写清楚,下次还会踩同一个坑。
有用的报告长什么样?大概是这样:DNS 切换后第八分钟,部分安卓客户端仍连旧地址。数据库切换后,订单查询接口超时两次,原因是连接池没预热。监控告警比实际故障晚了四十秒。回切时,运维找不到堡垒机审批人。每一条都难看。每一条都值钱。
演练还可以故意加故障。拔一根线,杀一个节点,模拟一个可用区断网。当然要在可控范围。别把生产当演练场。也别把演练当表演。表演多了,人就麻木了。真出事时,本能反应是找剧本,不是找问题。
说到底,灾备演练不是一年一次的仪式。它是一次压力测试。测系统,也测人。测流程,也测信任。设备可以买,流程可以写,但敢在关键时刻说“等等”的人,得靠平时练出来。
下次演练,别只盯大屏。听听谁在说等等。那个等等,可能就是真故障时救命的几秒。