链路追踪别急着上全家桶
2026-11-17 04:27:30
作者:
fawen
凌晨两点,订单服务超时告警。你打开日志平台,grep 订单号,三个服务都回了 200,中间那个库存服务说“等待锁超时”。然后呢?没有然后。请求像钻进一条黑巷子,出来时只剩结果,过程全丢了。链路追踪就是那支手电筒。不是银弹,但没它,排查全靠猜。
先搞清一张调用链到底长什么样
一次用户点“提交订单”,背后可能经过网关、订单、库存、优惠券、支付、消息队列。链路追踪给这次请求发一个全局唯一的 TraceId,每经过一个服务或一段逻辑,就记一个 Span。Span 有开始时间、耗时、状态、父子关系。父 Span 是入口,子 Span 是下游调用。拼起来就是一棵树,或者一条带分叉的链。就这么简单。真的。
 微服务链路追踪TraceId与Span调用链结构图
难点不在画图。在“上下文传播”。TraceId 怎么从网关传到订单,再从订单塞进 HTTP Header 给库存?库存异步丢到 MQ,消费者怎么接着用?线程池里换个线程,怎么不丢?这些地方才是链路追踪的命门。很多团队接完 SDK,发现链路断成几截,不是工具不行,是传播没做全。
别一上来就追求全量 采样是要花钱的
链路追踪的数据量很吓人。一个日均千万请求的系统,每个请求 20 个 Span,一天就是 2 亿条。存储、索引、查询,都是成本。所以采样是必须的。头部采样简单,在入口决定采不采,缺点是可能漏掉慢请求。尾部采样更聪明,等链路结束,按耗时或错误率决定留不留。贵,但值。
 分布式链路追踪采样策略对比示意图
我见过小团队硬扛全量,三个月后 ES 集群天天告警。也见过另一个极端:只采 0.1%,线上出问题刚好没采到。怎么办?按业务分级。核心支付链路 100% 或者高比例,后台报表 1% 就够。错误请求尽量全留。慢请求单独加规则。别拍脑袋,先看账单和查询需求。
还有个坑:TraceId 要打进日志。不然链路平台查到了,日志平台还得再搜一遍,体验割裂。统一日志格式,MDC、Logback、结构化日志,把 trace_id 和 span_id 带上。这一步的收益比换工具大得多。
选型不是选信仰 先看团队的手
 选型不是选信仰 先看团队的手
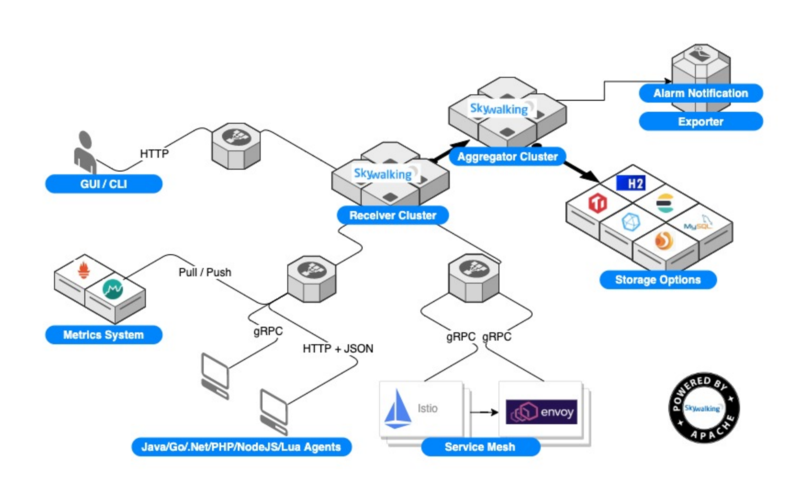
OpenTelemetry 现在很热。它想统一埋点和导出标准,方向对。但别以为接上 OTel 就万事大吉。SDK 版本、自动埋点覆盖、语言支持、后端存储,都得试。Jaeger 查询舒服,适合 Kubernetes 环境;SkyWalking 对 Java 生态友好,UI 和告警集成多;Zipkin 轻,老项目常见。选哪个?看团队最熟什么。运维能维护,开发愿意查,比功能列表重要。
不过话说回来,链路追踪不是孤岛。它得和指标、日志、告警串起来。看到 P99 飙高,能一键跳到慢 Trace;看到错误 Trace,能关联到具体日志。这叫可观测性。只买一个链路追踪系统,别的不管,最后还是会回到 grep。
落地行动清单 从一条核心链路开始
 落地行动清单 从一条核心链路开始
- 挑一条最痛的核心链路,订单或支付,别全站铺开。
- 统一 TraceId 生成规则,网关入口必须生成,没有就拒?至少记录。
- 打通 HTTP、gRPC、MQ、线程池的上下文传播。每个都要测。
- 日志加 trace_id,查询入口统一。
- 采样策略先保守,核心全采,边缘低采,错误全留。
- 每周看一次慢 Trace,别等出事。
边界也得说清:如果系统只有三五个服务,请求量小,日志里塞个 request_id 也能活。链路追踪的价值在服务多、调用深、团队分治的时候才明显。别为了简历上写“可观测性建设”硬上。
链路追踪像监控摄像头。装的时候嫌烦,出事时真香。但摄像头不会自己破案,得有人看录像,有人标时间线。工具是工具,流程是流程。先把 TraceId 传明白,再谈 AIOps。对吧。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
链路追踪别急着上全家桶
文章链接:https://m.itcdj.com/news/880.html