凌晨两点,我盯着Jenkins那个蓝色的圆圈。
它没转。
第17次构建失败了。同事在群里甩了个表情包过来,我没力气回。这就是我第一次硬推CI/CD时的真实画面。不是博客里写的那种效率翻三倍。不是。
说实话,那会儿我对持续集成的理解,停留在“提交代码自动打包”这个层面。太浅了。
后来我才慢慢明白,CI/CD压根不是装个Jenkins、写个Jenkinsfile就完事的东西。它更像一面镜子——照出来的是你们团队协作的混乱程度,仅此而已。
那晚的红色报错不是工具的问题
具体说。
那天构建失败的原因五花八门。有个同事把本地配置文件提交上去了,里面全是他自己电脑的路径。还有一个接口测试,依赖了另一个服务的测试环境,而那个环境恰好有人在上面改数据。最离谱的是一个依赖包的版本冲突,本地跑得好好的,服务器上就是不行。
这些问题,Jenkins一个都解决不了。
它只是把问题提前暴露出来了。以前没有流水线的时候,这些坑都堆到上线那晚才爆。现在提前爆了,大家反而觉得是CI/CD的锅。你看,这逻辑多荒唐。
工具从来不是解药。它是放大镜。
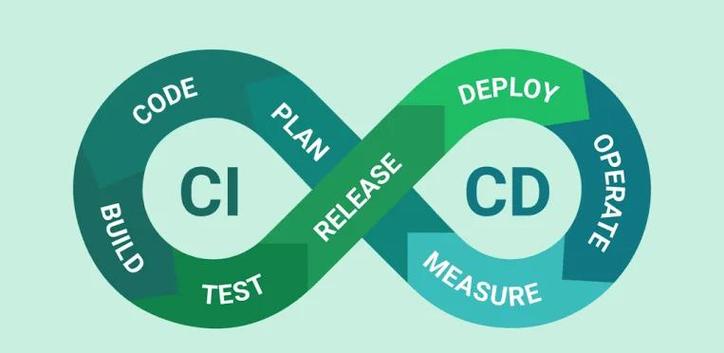
流水线跑通了就等于CI/CD做对了吗

我见过不少团队,流水线天天是绿的,但团队照样累得跟狗一样。
为什么?因为他们的CI只是把代码编译了一遍。跑几个测试用例,凑个覆盖率数字,就完事了。
这里得拆一下概念。持续集成(CI)的核心,其实是频繁地把代码合并到主干,并且每次合并都经过自动化验证。注意,重点在“频繁”两个字。一天合并一次和一天合并十次,是完全不同的两种东西。
持续交付(CD)呢,是把通过验证的代码自动部署到测试环境、预发环境,随时可以上生产。持续部署则是连生产那一步也自动化掉。
那很多团队卡在哪儿?
卡在信息反馈太慢。
一个提交,等半小时才告诉你挂了。谁还有耐心改。于是大家开始在本溿攒代码,攒一大堆再提交。这时候CI就名存实亡了。
流水线的价值,不在于它能不能跑通,而在于它跑得够不够快。
这个“够快”的线,我个人的经验是十分钟以内。超过这个数,开发者就会开始做别的事,然后彻底忘掉这个提交。上下文切换的代价,比你想的大得多。真的。
那些看起来很美其实很坑的做法
说几个我踩过的坑。
盲目追求100%测试覆盖率。覆盖率是个指标,不是目标。为了凑数字写一堆没有断言的测试,等于给流水线增加噪音。真正的测试应该是贴近业务行为的,而不是机械地调用一遍函数就完事。
把所有环境都塞进一条流水线。有的人喜欢一条流水线从开发一直跑到生产。听起来很爽。实际上一旦中间某步卡住,整个团队都堵在那儿干瞪眼。更好的做法是分段,每个阶段有自己的触发条件和责任人。
构建产物每次重新编译。这个坑很深。同样的代码,在测试环境编译一次,在生产环境又编译一次,理论上结果一样。实际上呢?依赖源可能变了,编译参数可能不一样。正确的做法是一次构建,处处部署。构建出来的产物就应该是那个不可变的镜像或者包。

如果重来一次我会怎么做
说说我现在的做法。不一定适合所有人,你挑着看。
先把主干保护起来。合并请求必须通过流水线才能合。这是底线。没有这个,后面全是空话。
让流水线在五分钟内给出第一次反馈。静态检查、单元测试先跑,慢的集成测试放后面。开发者在等的时候,最需要的是“我这次改的东西有没有低级错误”这个信号。
环境要像代码一样管起来。Docker也好,别的方案也好,重点是让每个人的环境一致。那个“在我电脑上能跑”的梗,应该被彻底消灭掉。
别指望一步到位。CI/CD是个持续演进的东西。今天能自动跑测试,明天能自动部署到测试环境,后天再说生产的事。慢慢来。急不得。
那晚的第十七次失败之后,我们改了很多。现在流水线还是偶尔会红。不过大家的心态不一样了——红灯不是灾难,它只是个信号。它在说,嘿,这里有东西需要看一下。
挺好。