实时计算任务的资源调优 一线运维的真实取舍
2026-11-12 18:48:16
作者:
fawen
上周跟一个做车联网实时数仓的朋友撸串,他说上周为了扛住大促的实时告警延迟,把三个核心任务的内存往上拉了40%,结果第二天凌晨整个集群被挤爆,两个非核心的用户画像任务直接挂了,排障到四点半,眼都红了。
先把“调优”两个字从神坛拉下来
这事没那么玄。
很多人一提到实时计算任务的资源调优,就觉得要背完整个Flink、Spark的源码,要能对着火焰图逐行抠函数栈。说白了,大部分线上跑的实时任务,根本没到需要抠代码粒度的程度。你先算明白三个数:任务的平均CPU使用率,单条数据的处理耗时峰值,状态后端的存储增长速率。就这三个数,够解决80%的资源浪费问题。
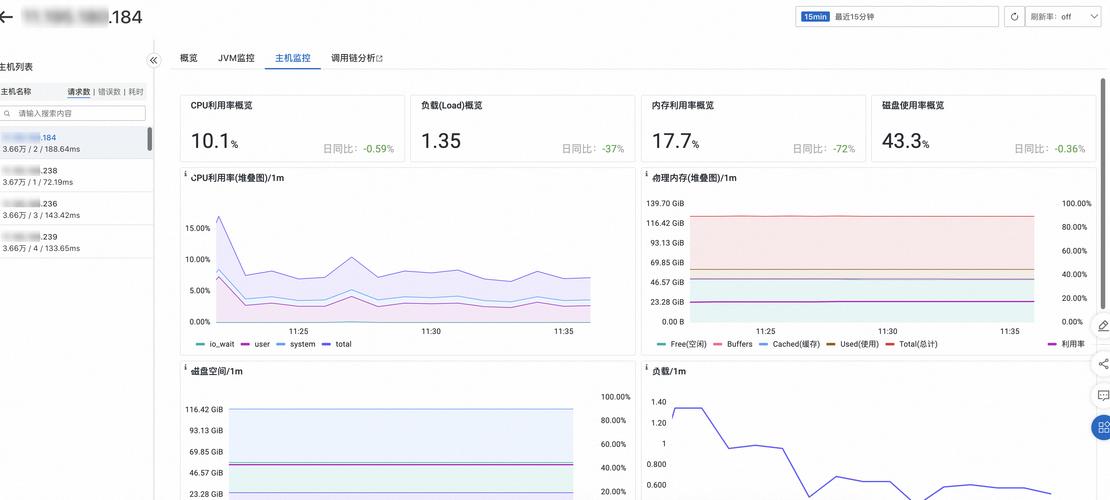 实时计算任务CPU内存使用率监控趋势图
我之前见过最离谱的配置,一个做实时PV统计的任务,给开了20个Slot,每个Slot配4G内存,结果跑了三个月,平均CPU使用率才12%,剩下的资源全在空转,集群管理员每个月看账单都要骂一次。为什么会出这种问题?因为很多人配资源的逻辑是“上次跑这个任务没报错,那我就多给点,省得以后出问题”。
多给的那部分资源,根本不会带来任何稳定性提升,反而会把整个集群的可调度容量吃掉一大块。代价是什么?是其他真正需要资源的任务,排不上队,启动要等十几分钟,延迟从百毫秒级飘到秒级,业务方找上门来骂的时候,你总不能说“我是为了稳才留的冗余”吧。
说实话,我刚接触实时计算的时候,也犯过这个错,总觉得给的资源越多,任务就越稳,结果把自己负责的任务占了快三分之一的集群资源,最后被管理员约谈的时候,脸都发烫。
别盯着单任务的最优解死磕
麻烦在于,很多人调优的时候,眼睛只盯着自己负责的那几个任务,算出来这个任务给3个核就够,非要给5个,觉得“这样更稳”。但你算过整个集群的账吗?
比如你所在的集群总共1000个核,你管的10个任务,每个多留2个核的冗余,加起来就多占了20个核。这20个核,能给两个需要跑实时风控的核心任务留足突发流量的缓冲空间。
之前在园区采访的时候,碰到过一个团队,一开始每个实时任务的资源配置都是按峰值流量的1.5倍给,算下来每个任务都特别稳,从来没出过OOM,结果集群整体的资源使用率才不到30%,每个季度付云资源账单的时候,财务都要拿着表找技术负责人谈话。后来他们把配置规则改成“日常峰值给1.1倍冗余,突发流量靠集群的弹性预留池兜底”,整体使用率一下拉到了65%,压根没增加故障,反而因为预留了足够的弹性空间,大促的时候扛住了三倍的流量峰值,比之前的稳多了。
 实时计算集群资源调度队列配置界面截图
这里的取舍很实在:你是要单任务跑起来丝滑,从来不报错,还是要整个集群的资源不浪费,能接住真正的流量峰值?没有绝对的对错,但你不能两头都占。很多人调优调得很累,就是既想让自己的任务多占资源,又想让整个集群的调度不排队,哪有那么好的事。
上次碰到个工程师,跟我吐槽说他为了让自己的任务不被抢占,特意把资源申请得比实际需要多一倍,结果上周集群做版本升级,管理员直接把他占的空转资源划走了,他还闹了半天,说之前的配置不能动。这话说出去谁信啊,你那任务CPU跑10%,占着8G内存,换你是管理员你不划走?
那些藏在细节里的隐性成本
很多人算资源的时候,只算CPU和内存的硬开销,忘了算那些隐性的成本。
比如状态后端的大小。很多实时任务跑着跑着,状态越攒越多,从一开始的几个G,涨到几十G,甚至上百G。这时候你给的内存如果刚好卡着数据处理的量,没给状态留足够的空间,那到了Checkpoint的时候,就会出现同步阻塞,整个任务的处理延迟直接往上跳。
还有网络的开销。两个相邻的算子之间,如果数据传输的量特别大,你哪怕给再多的CPU和内存,只要网络带宽卡了,任务照样会出现反压。这时候你再怎么加内存,都没用,白花钱。真的。
真正的调优从来不是把资源往多了给,而是把每一份资源花在真正卡脖子的环节上。比如你发现任务的瓶颈在网络传输,那就把多余的内存预算砍一半,把省下来的钱换成更高带宽的实例,比你瞎加内存管用十倍。
我之前见过有人为了处理一个延迟尖刺,给每个TaskManager加了2G的堆外内存,结果折腾了一周才发现,瓶颈根本不在内存,是上游的数据源在某个时间点批量推了10倍的数据进来,把网络带宽打满了。最后把数据源的批量推送改成流式发送,延迟直接降回去了,加的那堆内存全成了摆设。
还有个很容易被忽略的点:任务的并行度不是越高越好。很多人觉得,我把并行度从10提到20,处理速度肯定更快。但你有没有算过,并行度提上去之后,每个Slot的状态要做同步,网络要做shuffle,这些额外的开销,可能会把你拿到的处理速度优势全吃掉。我见过最夸张的,一个简单的字符串过滤任务,并行度开了100,结果整个任务的处理延迟比并行度20的时候还高了30%,原因就是shuffle的网络开销太大,所有的算子都在等网络传输,根本没在处理数据。
其实实时计算任务的资源调优,从来没有什么放之四海而皆准的公式。你今天觉得合适的配置,可能下个月业务涨了,数据量翻了倍,就完全不适用了。别总想着找一个万能的配置模板,拿过来就能一劳永逸。多蹲几次监控面板,多看看每次报错的日志,多算几次集群的整体账单,比你背十本技术手册管用。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
实时计算任务的资源调优 一线运维的真实取舍
文章链接:https://m.itcdj.com/news/759.html