上周跟做电商的朋友喝咖啡,他刚因为缓存和数据库不一致赔了三万多的优惠券。说白了,就是大促的时候改了商品库存,缓存没刷对,用户付了款发不出货。这事没那么玄,就是分布式缓存一致性保障里最常见的双写问题。
先搞懂你要解决的到底是什么问题
很多人上来就把一致性分什么强一致、弱一致,听得人云里雾里。其实本质上就是两个独立存储节点的写操作顺序问题。你要写数据库,还要写缓存,两个操作不在同一个事务里,总有先后,总有时间差。就会有那么一个极短的窗口,两边存的数不一样。

别跟我扯什么教科书里的完美方案。真跑在线上,什么网络闪断、请求超时、节点重启,全是你写代码的时候想不到的意外。我之前采访过一个做社区产品的技术负责人,说他们之前为了追求所谓的“零不一致”,搞了分布式事务把缓存和数据库的写操作绑在一起,结果大促的时候整体接口延迟涨了三倍,最后还是把那套方案拆了。
说白了,你得先搞清楚自己的业务能容忍多久的不一致。是能容忍1毫秒,还是能容忍1秒,还是能容忍10秒。这个数定不下来,后面所有的方案都是瞎折腾。
别上来就追求绝对一致
真的。大部分场景根本不需要强一致。
绝大多数业务场景下,最终一致就够用了。
比如商品详情页的简介,晚个几百毫秒更新,用户划走都不会注意到。比如用户的头像地址,就算缓存里存的是旧的,刷新一下就好了。为了这点感知不到的差异,你要加分布式事务,要加锁,要做一堆额外的校验,平白把系统的复杂度拉满,太亏了。
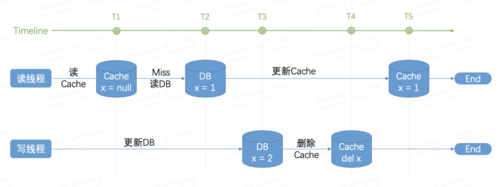
当然也有不能马虎的场景。比如库存数,比如账户余额,这些涉及到钱的,一致性要求就高。但就算是这些场景,你也不用追求绝对的实时一致。只要保证最终不会出现超卖,不会出现账实对不上,就够了。我之前碰到过一个做票务系统的团队,他们处理电影票库存的方案,就是给缓存设了10秒的过期时间,就算中间出现不一致,用户最多等10秒,缓存自动刷新成最新的数据库值,根本不会出现超卖的情况。简单,有效,成本还低。
很多人聊分布式缓存一致性保障,总觉得是要搞一套多么复杂的架构,其实大部分时候,把几个基础的坑填上,就能解决90%的线上问题。
不过话说回来,要是你做的是金融交易系统,那当我没说,该上强一致还是得上。
几个真能落地的实操细节
先说大家都听过的延迟双删。很多人用这个方法,都是随便写个固定的延迟时间,比如500毫秒。错。
延迟时间的设置没有标准答案,全靠自己压测出来的实际链路耗时定。
说实话,这个方案我第一次用的时候,也踩过这个坑。你得算上数据库主从同步的时间,算上缓存读请求的平均耗时,甚至要算上消息队列的消费延迟。我之前见过有人把延迟设成100毫秒,结果数据库主从同步就要200毫秒,他删的时候,从节点还没把最新的数据同步过来,等从节点同步完,那个旧的缓存值早就被读请求塞回去了,等于白删。
然后是订阅binlog的方案。这个方法现在挺多人用,就是把数据库的所有变更操作,通过binlog同步到消息队列,然后专门的消费程序去监听这些变更,拿到变更的key之后,主动去删对应的缓存。说白了,就是把删缓存的操作从业务代码里剥出来,不用你在每一个写数据库的接口里都记得要删缓存,也不会出现某个开发改代码的时候漏写了删缓存的逻辑。这个方案的好处就是解耦,业务代码不用关心缓存的事,只要数据库改对了,后面的缓存更新自动就跟上了。
对了,一定要设缓存过期时间。
缓存过期时间是成本最低的兜底方案。
别觉得自己的逻辑写得滴水不漏,线上什么奇葩情况都能碰到。我之前碰到过一次缓存集群的网络闪断,我们发出去的删缓存请求,因为网络包丢了,根本没到缓存节点,结果那个key的旧值就一直存在缓存里。还好当时我们给那个库存key设了30秒的过期时间,不然真的要出大问题。
真的,做技术别追求完美。分布式缓存一致性保障这事,从来不是要做到百分百没有任何不一致的情况,而是要把不一致的窗口缩到最短,把出现问题后的恢复成本降到最低。你要花10倍的成本,把不一致的窗口从100毫秒缩到1毫秒,带来的业务收益可能还抵不上你多写两行过期时间代码的效果。
别钻牛角尖。