凌晨两点 那张报表又背锅了
凌晨两点,群里有人@你。报表数字不对。老板在等。你打开调度平台,一百多个任务在跑。哪个环节把字段改了?没人说得清。
这就是数据治理中的数据血缘追踪最该出现的时刻。不是评审会上,不是数据资产大屏上。是故障现场。是有人问“这个数从哪来”的时候。
但很多团队的血缘追踪,平时躺在元数据平台里。好看。点开也能看到一张图。真出事,大家还是拉群、翻代码、问上游。为什么?
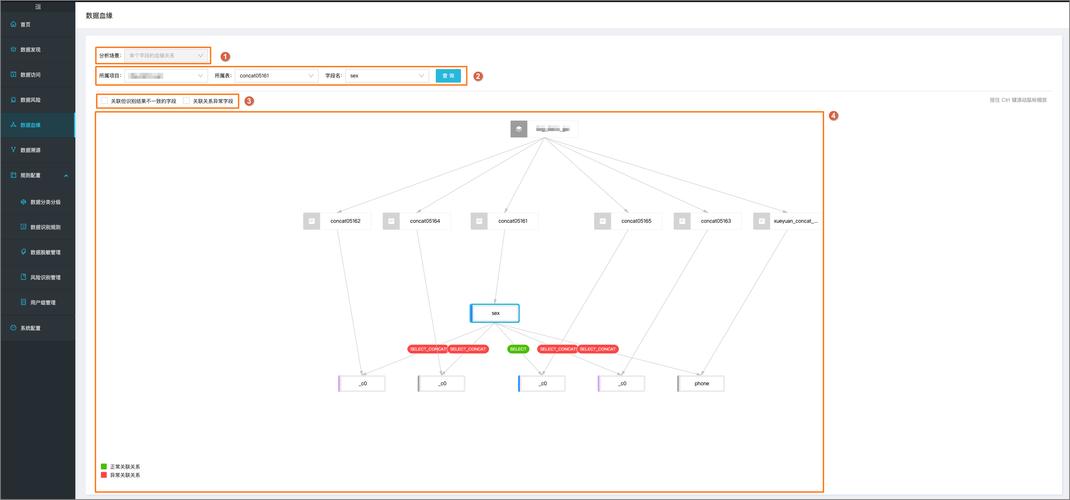
因为血缘没接到工作流里。它只是一个页面。不是一个动作。
血缘不是画一张漂亮地图
我见过一些数据治理项目,把血缘当成交付物。采集一批SQL,解析出表级关系,画成拓扑图。验收通过。然后呢?没人用。
问题不在图。问题在粒度、时效和置信度。
表级血缘只能回答“这两张表有关系”。字段级血缘才能回答“这个指标里的GMV字段,被哪个任务里的哪个表达式改过”。两者成本差很远。表级靠SQL解析,几天能出原型。字段级要处理嵌套、别名、窗口函数、动态SQL、UDF。麻烦得很。
任务血缘、指标血缘、报表血缘,又是另一层。一个看板上的数字,背后可能是调度任务、临时脚本、人工补数、甚至Excel上传。你不把这些串起来,血缘就是断的。
技术路线大概几种。SQL解析,覆盖静态离线任务,便宜,但实时和动态SQL容易漏。运行时埋点,从Spark、Flink、Hive hook里抽,准,侵入大,维护累。日志解析,介于两者之间,脆。开源方案有Atlas、DataHub、Marquez、OpenLineage。商业工具更多。选哪个?看团队规模,看能忍多少脏活。

说实话,字段级血缘像剥洋葱。剥到第三层,眼睛已经睁不开。很多团队做到表级就停了。不是不想,是算不过账。
落地要从故障场景倒推
别从元模型开始。从“谁在什么场景下会打开血缘”开始。
运维要排障。数据质量告警响了,他需要知道这个表的上游是谁,最近哪次任务变更可能影响它。血缘要能自动带出子图,最好附上变更记录。
开发要改SQL。提交代码时,他想知道这个字段下游有哪些任务、哪些指标、哪些报表。如果CI里能提示“你正在影响三个核心看板”,他会谨慎。不是靠制度,是靠工具。
分析师要解释口径。这个指标为什么和另一个对不上?血缘能追到计算逻辑和中间表。但前提是能看懂。别给一堆技术节点,得翻译成人能读的路径。
合规和审计要追责。这笔数据从哪来,经过了谁,有没有跨域。血缘是证据链的一部分。但权限要控制。血缘本身可能暴露敏感表名。
所以落地顺序可以很土:先接调度,再接数据质量,再接指标平台。先覆盖核心链路。交易、订单、风控、财务。别一上来全公司。全公司等于全没有。
血缘会腐烂。今天准,明天任务改了,血缘没更新,就成假图。要有自动化采集,也要有人工校验。置信度低的关系,标出来。别假装完整。
一个不算成功的案例

有个做零售的团队,花了半年做血缘。图谱挺漂亮。结果一次大促后,报表口径对不上,大家还是拉群问。为什么?血缘没接告警。字段级只覆盖三成。权限卡得死,分析师看不到。
后来他们换了个做法。不追求覆盖率,先把血缘嵌到告警消息里。告警一出,自动附上上游任务和最近变更。排障时间降了。代价也有:埋点改造拖了两个月,开发骂娘。但至少有人用了。
这事没那么玄。血缘追踪不是数据治理的装饰品。它是故障时的地图。地图旧了,比没有更危险。
别指望一劳永逸

数据源会变。任务会变。人也会变。今天负责订单表的人,下个月可能转岗。血缘追踪得跟着组织走。
小团队怎么办?先用调度器自带的血缘。Airflow、DolphinScheduler、DataWorks,都有基础能力。别一上来就自研图数据库。规模没到,那是给自己挖坑。
大团队呢?要考虑存储和查询。一个字段下游几千个节点,前端不能全画。要聚合,要分层,要按影响级别过滤。图数据库Neo4j、NebulaGraph可以用,但别为了技术时髦。先问查询模式。
还有成本。解析SQL要算力。埋点要改代码。存储血缘要空间。维护规则要人。这些账,立项时没人爱算。出事时全来找你。
天快亮了。你关掉图谱页面。下次改SQL前,至少会多看一眼下游。这就算没白干。