线上告警响了。库存扣了两次,订单状态还是旧。追了一圈,问题不在数据库,在缓存。
分布式缓存一致性保障,说白了就是让缓存别撒谎。可缓存天生会撒谎。它离用户近,离数据库远,中间隔着网络、主从复制、消息队列,还有并发请求。你想让它绝对准,代价立刻上来。
删缓存还是更新缓存 这事吵了十年
Cache Aside 最常见。读的时候先查缓存,没有就查库,再写回缓存。写的时候呢,先更新数据库,再删除缓存。听起来顺。麻烦在并发。
假设两个请求。A 更新数据库,把值改成 2,然后删缓存。B 在 A 删缓存之前读缓存,读到旧值 1。或者更糟,B 在 A 删缓存之后、更新数据库主从延迟还没同步时,读到从库旧值 1,又把 1 写回缓存。完了。缓存里躺着 1,数据库主库是 2。下一次读还是 1,直到 TTL 过期。

有人问,能不能先删缓存再更新数据库。也不行。删完缓存,数据库还没更新,另一个读请求把旧值拉回来,照样脏。
所以大家开始用延迟双删。更新数据库前后各删一次,中间睡几百毫秒。这个做法能缩小窗口,但睡多久?靠猜。业务写入越频繁,猜错的概率越高。而且睡眠阻塞线程,吞吐直接掉。异步删?又回到消息可靠性问题。
还有一种思路:更新缓存而不是删除。谁更新?写请求更新。如果写多读少,缓存很快变成写放大现场。如果读多写少,更新缓存可能让缓存里全是中间态。除非配合版本号,每次写带递增版本,读的时候比较版本,旧版本不覆盖新版本。这招有用,但版本号从哪来?数据库自增、Redis INCR、时间戳加机器位。都有坑。时间戳回拨一次,你就知道疼。
延迟双删和消息队列 只是把窗口变窄
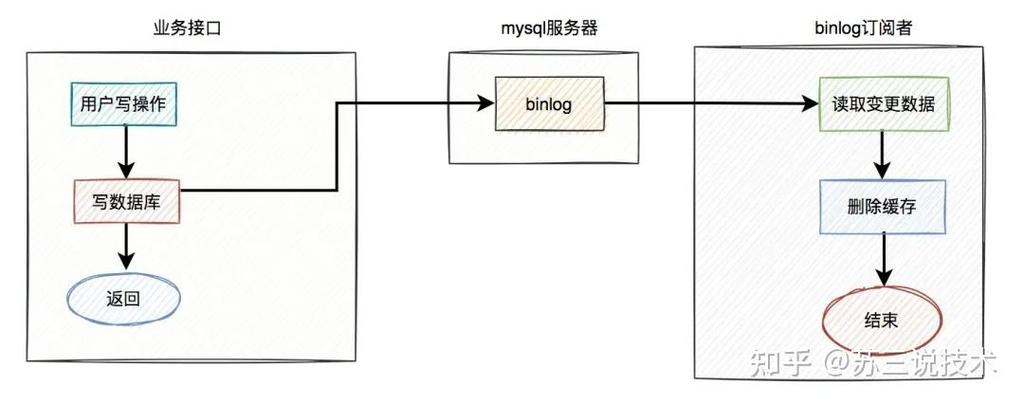
更工程化的做法是订阅数据库 binlog。数据库提交后,binlog 发到消息队列,消费者负责删缓存。这比业务代码里双写靠谱。至少数据库事务成功,binlog 一定在。问题也有。binlog 到 MQ 有延迟。MQ 重复、乱序、堆积。消费者删缓存失败怎么办?重试。重试到什么时候?死信队列。人工介入。
我见过一个团队,库存缓存用 binlog 删。大促时 MQ 堆积,删缓存延迟了十几秒。前端读到的库存全是旧的。用户下单,到了扣减环节才发现没了。体验很糟。后来他们加了一层本地缓存过期时间,缩短到 1 秒。还是脏,但脏得不久。说白了,这是拿一致性换可用性。
那分布式锁能不能救?能,但贵。读请求也加锁,写请求也加锁,缓存和数据库串行化。吞吐掉一个量级。Redlock 还有争议,主从切换时锁可能丢。锁没丢,网络分区也可能让两个客户端同时以为自己拿到锁。所以锁适合对账、迁移、极少数强一致场景,不适合扛高并发读。
强一致还有一条路:读写都走缓存,缓存做唯一真相。Redis 持久化加主从同步,再加 WAIT 命令。问题是 Redis 不是为强一致设计的。主从异步复制是默认。WAIT 只能保证副本收到,不保证落盘。节点故障时还可能丢。你要强一致,就得接受延迟和可用性下降。CAP 不是选择题,是账单。
最终一致要能兜底 对账比锁更管用

大多数业务其实要的是最终一致。缓存旧几秒,能忍。但脏了不恢复,不能忍。所以兜底机制比删缓存本身更重要。
常见兜底有三层。第一层,TTL。所有缓存必须有过期时间。别设永久。TTL 是最后的安全网。第二层,版本号或业务时间戳。写缓存时带上版本,读的时候如果发现缓存版本低于数据库版本,触发异步刷新。第三层,对账。定时任务抽样比对缓存和数据库。发现不一致就删缓存、告警、记录。对账不用全量,抽样就行。全量对账能把数据库拖垮。
还有个容易忽略的点:主从延迟。你读数据库可能读从库。从库落后主库几百毫秒,甚至几秒。这时候你拿从库旧值回填缓存,等于把延迟放大。所以回填缓存最好走主库,或者至少判断 GTID 是否追上。麻烦在于,很多框架默认读从库。你写代码时觉得没问题,出事时才发现。
多级缓存更刺激。JVM 本地缓存加 Redis。Redis 删了,本地缓存还在。每个节点各自为政。你得靠广播失效。广播走 MQ 或 Redis PubSub。PubSub 不持久,节点掉线期间消息就丢了。掉线节点恢复后,本地缓存可能还是旧的。所以本地缓存 TTL 要更短,且启动时清空。别偷懒。
监控和代价 别等用户告诉你缓存脏了

一致性保障做得好不好,不看架构图,看监控。有几个指标必须盯。缓存命中率突然掉,可能是大量删缓存。缓存和数据库差异采样数上升,说明兜底没兜住。删缓存失败重试次数,MQ 堆积量,binlog 延迟。这些指标比 QPS 更能提前报警。
但监控也有成本。采样对账会打数据库。实时对账更贵。所以很多团队只在核心链路做,比如订单、库存、支付。非核心链路,TTL 加告警够了。别一刀切。
最后说句实话。分布式缓存一致性保障没有银弹。先更新数据库再删缓存,配合 binlog 订阅、版本号、TTL、对账,能覆盖大多数场景。强一致场景,要么别用缓存,要么把缓存做成唯一真相并接受延迟。最怕的是,既想要缓存的高性能,又想要数据库的强一致,还不愿意做对账和监控。那线上一定会教你做人。