高可用架构不是堆出来的
2026-11-01 03:36:23
作者:
fawen
去年618前三天,我被杭州一个电商团队拉去救急。
他们刚花了大价钱上了双活机房,运维拍着胸脯说这次绝对不会崩。
结果预热第一天,库存接口直接卡成PPT,后台告警炸了三屏,客服电话被打爆到占线。
我蹲在他们机房的临时工位上看了俩小时日志,差点气笑。
所谓的双活,就是把同一套代码往两个机房各扔了一份,流量切了50%过去,连数据库主从延迟多少都没测过。
他们的库存接口用的是本地内存缓存,A机房扣了100件货,缓存里减了100,B机房的缓存还是原来的2000,结果预热半小时就超卖了300多单,接口为了防止超卖直接锁死,谁都别下单。
你以为的高可用,可能只是”看起来很能用”
很多团队对高可用的认知,还停留在“多买几台服务器、租两个机房、把代码扔上去”的阶段。
我见过太多团队给老板汇报的时候,画一张五颜六色的多机房架构图,把高可用的概念吹得天花乱坠,实际连一次完整的故障切换演练都没做过。
有个做在线教育的团队,说自己做了熔断降级,结果熔断阈值设的是CPU跑到100%才触发,等真到那时候,整个服务早就卡成砖头了,熔断根本来不及生效。
 电商大促库存接口宕机告警日志截图
说白了,这种高可用就是演出来的——平时看着啥都有,真遇到事的时候,该崩还是崩。
钱花了不少,老板看着也满意,就是用户用的时候骂骂咧咧。
高可用的核心从来不是”不挂”
很多人对高可用有个误解,觉得就是要所有服务都永远不挂,连一秒的中断都不能有。
根本不是。
高可用的本质,是把故障的影响控制在业务能接受的范围内,而不是追求绝对的零故障。
我之前待过的外卖团队,午高峰的时候,用户评价接口突然挂了,根本不影响用户点单、骑手取餐、商家接单,那这个接口挂了就挂了,甚至不用立刻紧急修复,等午高峰过了再说都行。但如果是下单接口或者支付回调接口挂了,哪怕一秒,都是要拉响最高级别的告警。
所以做高可用之前,首先要做的就是核心业务分级,别上来就全链路铺资源。
P0级的核心服务,比如下单、支付、核心库存,要做到多机房容灾,甚至单元化部署,挂一个机房整个业务还能正常跑。P1级的服务,比如订单查询、骑手位置更新,做同城双活就行,没必要跨地域。P2级的非核心服务,比如运营后台、用户兴趣标签,甚至可以允许挂半小时,根本不用花大价钱做冗余。
不过话说回来,也不是说非核心服务就可以随便放着不管,只是投入的资源可以和优先级匹配,别把钱都砸在没用的地方。
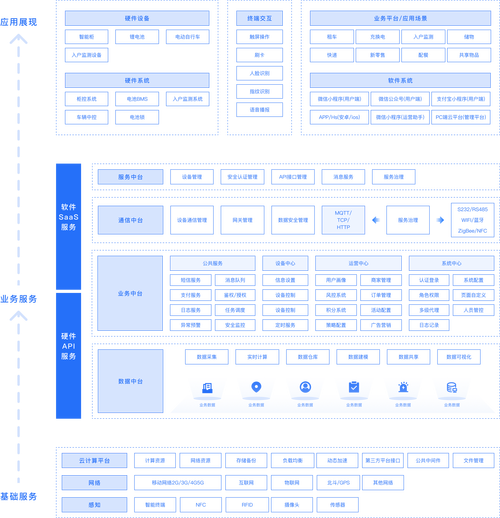 外卖业务核心服务分级架构示意图
我见过最离谱的一个创业团队,日活才十万,上来就抄了一套大厂的多活架构,光每个月的云服务器成本就多了十几万,结果连个最核心的下单接口的超时控制都没做好,高峰的时候还是卡得要死。
图啥呢?
别等出了事故才补窟窿
高可用不是一劳永逸的事,也不是买了一堆硬件就能解决的。
最容易被忽略的环节是常态化故障演练。
很多团队怕演练出问题,平时根本不敢动线上的服务,就怕不小心搞出线上事故,背锅挨骂。我之前在阿里的时候,每次大促前的混沌演练,都是直接随机杀线上的服务实例,甚至直接断一个机房的外网网络,运维和开发轮值守夜,出问题当场修。
印象最深的一次,我们第一次演练断机房的时候,整个技术群里半小时没人说话,最后发现流量切流的脚本写错了,把90%的流量切到了已经断网的机房,差点真的搞出大事故。但那次之后,我们把切流脚本改了三版,加了三层校验,后来再断机房,30秒就能完成全量切流,用户根本感知不到。
还有个很重要的点,高可用根本不是运维一个人的事。
开发写代码的时候就要考虑容错,比如接口要做幂等性——也就是同一个请求发十次,结果和发一次一样,别出现用户点一次付款扣了十次钱的蠢事;还要做好超时控制,别写那种等数据库锁等个10秒的代码,运维再怎么堆服务器也扛不住这种坑。
说实话,我见过太多团队,把高可用当成一个可以抄的开源方案,或者可以花钱买的服务,拿过来就往自己业务上套。
根本不想想自己的业务体量是多少,核心痛点是什么。
真的没必要。
用户不会因为你有双活机房就多买你东西,但会因为你下单按钮点不动,下次再也不来了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
高可用架构不是堆出来的
文章链接:https://m.itcdj.com/it/345.html