上周在软件大道旁边的小馆子跟几个运维老炮拼酒,有人把杯子往桌上一墩,说去年咬咬牙上的AIOps,现在纯纯成了部门的电子摆设。
监控告警比以前还吵。根因分析出来的结果八竿子打不着。每月两万多的算力授权费照付,领导还隔三差五跑过来问,你们这AI都上了快一年了,怎么还没见着减人啊。
那些被销售吹上天的落地场景
当初厂商来做演示的时候,把功能吹得神乎其神。说能自动识别数据库慢查询,自动扩容,自动切流,甚至能在故障发生前30分钟给值班人员发精准告警,连处理步骤都给你列得明明白白。
真到自己家环境跑起来,完全不是那回事。告警阈值调了八遍,要么把正常的业务流量当异常拦截,要么半夜真出了磁盘满的故障,系统还在那慢悠悠算“当前指标处于历史正常区间3倍标准差以内”。
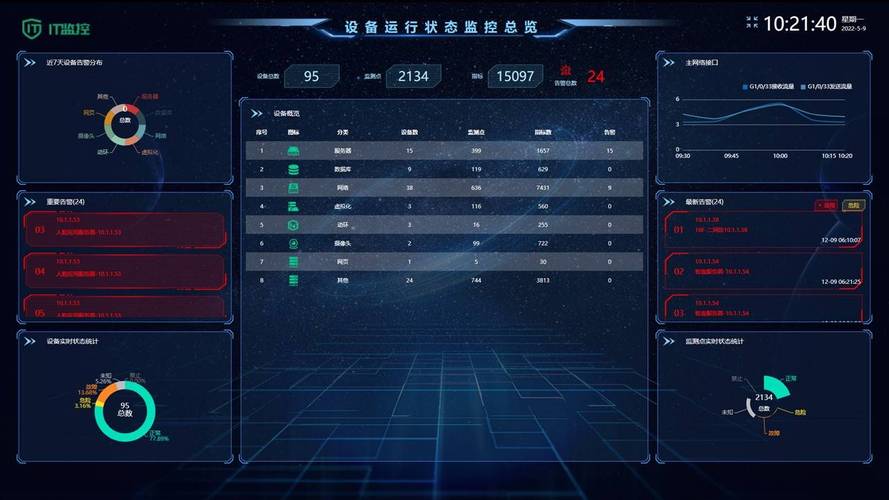
很多团队最开始冲AIOps的点,根本不是真的有迫切的运维痛点,而是看隔壁友商上了,自己不上好像技术落后一截。有个在雨花软件园做电商的朋友说,去年双11之前赶项目上的AIOps,结果大促当天系统识别到支付链路的流量突增,按照预设的模型直接触发了扩容——多开了47台云主机,事后算账单多花了12万。原因特别简单,模型根本没区分“大促活动的计划内流量”和“异常攻击流量”。
你说这闹不闹心。
大部分团队死在了数据基础上
很多人觉得AIOps难,是算法不够先进,模型精度不高。
错了。
真的聊过十几家落地踩坑的团队就知道,80%的问题根本不在AI本身。就拿最基础的日志采集来说,有的团队服务器日志散在十几个不同的存储节点,字段格式不统一,同一个服务的错误码,不同开发写的描述能差出十万八千里——有的写“连接失败”,有的写“timeout”,有的直接甩一句“数据库挂了”。
你让模型怎么识别?
说实话,这种数据基础,你就算把最顶尖的大模型搬过来,也得给你整出一堆错误结论。之前碰到个做金融的客户,一开始也踩过同样的坑,买了最贵的商业AIOps平台,跑了三个月,告警准确率还不到20%。后来咬咬牙停了所有的模型迭代,花了半年时间整理全链路的指标字典,把从客户端到接入层、应用层、数据库、中间件的所有指标的口径、阈值、关联关系全部理清楚,甚至把过去三年的所有故障工单全部标注了对应的根因标签,再把整理好的数据喂给模型。
这时候出来的效果,根本不是那种上来就买个SaaS平台能比的。平均故障定位时间从之前的40分钟降到了6分钟。
你看,差的根本不是那套几万块的软件,是之前没人愿意沉下心做的脏活累活。
别把AIOps当减人工具
很多领导对AIOps的认知特别奇怪,觉得上了这个系统,运维团队就能从20个人砍到5个人,剩下的人全去搞研发。
真的扯。
我见过最舒服的AIOps落地团队,根本没拿它当减人的武器,而是把运维人员从之前天天熬夜接告警、手动查日志、反复跑扩容脚本的机械劳动里解放出来,去做更有价值的事——比如优化全链路的架构稳定性,做长期的容量规划,甚至给开发团队提可落地的性能优化建议。
之前那个在雨花软件园做电商的朋友,把之前每天要处理的3000多条无效告警全部过滤完之后,值班的同学不用再凌晨两点爬起来处理误报,上个月还牵头做了一套针对大促场景的流量识别规则,把之前那种误扩容的问题彻底解决了。现在他们团队的人还是那么多,但所有人的工作状态完全不一样,再也没人天天吐槽“半夜被告警吵醒的日子不是人过的”。
最近碰到好多刚接触AIOps的同学,上来就问“哪个厂商的模型精度最高”“要花多少钱才能快速落地”。其实真的没必要着急。你先把自己家的无效告警理清楚,把日志的格式统一好,把过去的故障记录整理明白,再谈AI的事。