上周跟在软件大道做电商中台的老陈喝鸭血粉丝,他把手里的鸭肝夹到我碗里,说上个月618预演的时候,运营对着实时看板拍桌子骂娘的样子,现在还在他脑子里晃。
本来他们卡了阈值,只要实时进来的新用户量超过10万/分钟,就自动切流量到备用服务器,顺便给羊毛党加黑名单。结果看板延迟了整整8分钟,等运营反应过来点按钮,羊毛党已经薅走了二十万的无门槛券。
没人会为你量身定制参数。
你以为的实时,根本不是真实时
老陈他们之前总觉得,自己跑着Flink流任务,就是做实时计算了。直到出了这次事故才拉着链路排查,从用户点下APP按钮,到数据出现在看板上,整整走了快20分钟。
很多人对实时计算的认知还停留在“用了流处理引擎就是实时”的层面,根本没算过端到端的延迟账。真正能用来做决策的实时计算,端到端延迟必须压在10秒以内——不然等你看到数据,该爆的服务器已经爆了,该跑的羊毛党已经跑了,再做什么都晚了。
哦对,老陈说他当时看到延迟数据的时候,差点把手里的鸭血粉丝汤扣在桌上。
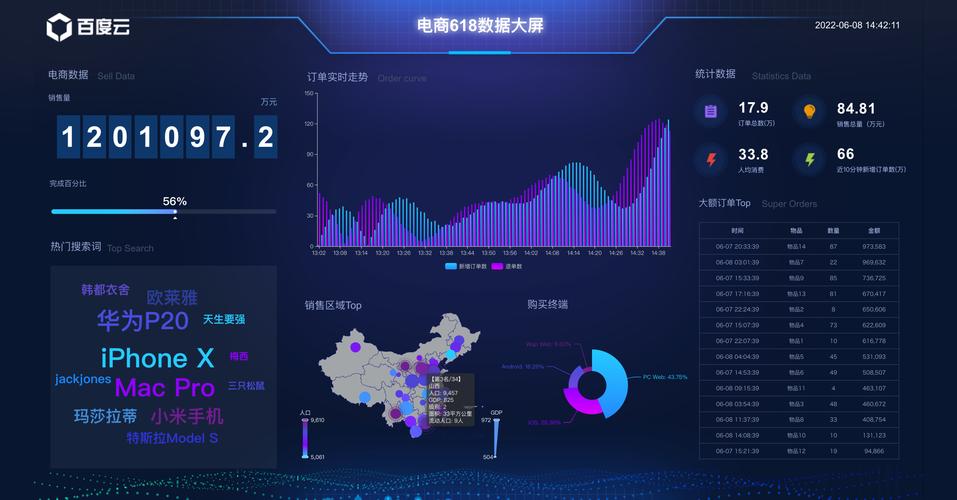
链路里藏着的那些隐形延迟
你说可笑不可笑,当初他们搭这套链路的时候,所有参数都是从网上抄的大厂“最佳实践”,谁知道大促的时候流量是平时的20倍,那些看似完美的配置全成了坑人陷阱。
排查下来一共三个最要命的隐形延迟:第一是埋点SDK为了省用户流量,攒够1000条数据或者10分钟才发一次请求,源头就慢了半拍;第二是Kafka的消费者组offset提交间隔设了5分钟,Flink每5分钟才拉一次新数据;第三是ClickHouse的写入是异步批量的,每攒够1万条才刷一次盘,前端看板的查询缓存还要等2分钟才过期。
后来他们改参数改了整整一周:埋点改成每1秒就发一次,哪怕丢1%的用户点击数据也没关系,实时场景下这点误差根本不影响决策;Kafka的offset提交改成每1秒一次;ClickHouse改成每100条就写入,端到端延迟直接压到了3秒以内。
上次正式大促的时候,运营刚看到羊毛党集中进来的提示,点了一下按钮,直接把损失压到了2000块。老陈说那天他站在运营背后,连大气都不敢出,结果居然成了。

别为了实时而实时
不过话说回来,我见过太多团队,花了几百万搭实时集群,最后就搞了个好看的大屏挂在前台,根本没人真的用。
老陈他们之前还跟风给行政做了个实时考勤看板,要求每10秒更新一次谁打卡了,结果行政根本不需要这个——他们要的是每天早上9点半出一次前一天的考勤汇总,你说这不是瞎折腾吗?
实时计算的价值从来不是“快”,而是“快到能帮你做决策”。如果你的业务场景,晚1小时看数据也不影响结果,那完全没必要上实时,用离线T+1的数仓就行,省钱还省心。
真的需要实时的场景其实没那么多:大促的流量监控、风控的反欺诈、外卖的派单调度、直播间的弹幕实时统计,这些都是晚10秒就会出问题的场景。其他的场景,没必要硬凑实时的热闹。
给想要落地实时计算的团队提两个实在的小建议:先问清楚自己的业务到底需要多快的延迟,是1秒?10秒?还是1分钟?别上来就追求毫秒级,成本会高10倍都不止;先从最小的链路跑通,别一开始就搞全链路改造,先拿一个最痛的场景跑通,算清楚成本,再慢慢扩。
上周再跟老陈去吃鸭血粉丝,他说现在他们的实时看板延迟稳定在2秒,上次大促运营再也没拍过桌子,就是偶尔会有埋点丢数据的小问题,不过没人在意。
老板还夸他们现在大促不忙了,经常能准点下班。