这事没那么玄。很多团队对消息队列的认知,还停留在“大厂都用,我也得用”的层面,根本没算过自己要为这个组件付出多少代价。
别把消息队列当万能胶水
消息队列解决的从来不是“系统高级不高级”的问题,核心就三个作用:异步、削峰、解耦。
听起来都对。但你真的碰到场景了吗?
比如团队总共就三五个开发,系统一天下来总请求量还不到一万,同步接口跑的好好的,非要上MQ做解耦——解完了谁维护?出了问题谁排查?说白了,这就是为了用组件而用组件,纯属给自己找事。
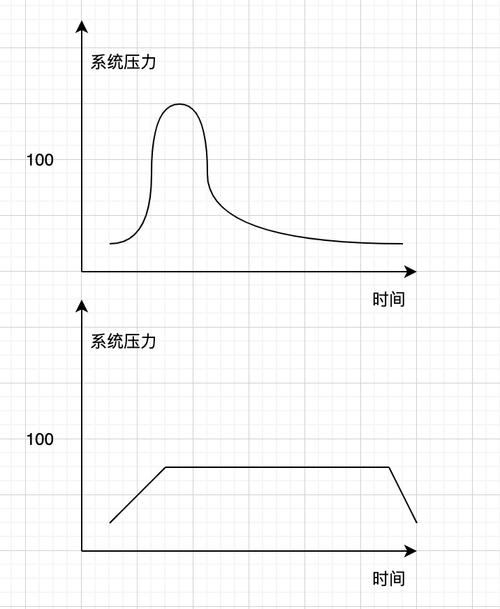
真需要用的场景其实很明确:比如你注册个账号,不需要等短信验证码发出去才给用户返回注册成功,完全可以把发短信的逻辑异步丢给下游;比如大促零点的流量是日常的15倍,直接打在数据库上肯定挂,中间隔一层MQ把流量削平,让下游服务按自己的处理速度慢慢消费,不至于直接被打崩;比如你原来的下单系统要同时调用库存、支付、积分、物流四个接口,任何一个接口挂了整个下单流程就走不通,把这些非核心的流程通过MQ串起来,就算积分系统临时出问题,也不影响用户先把订单付了。
对,就这些。没有什么花里胡哨的用法。
丢消息从来不是小概率事件
我见过太多刚接触MQ的开发者,写代码的时候逻辑简单到离谱:生产者把消息往Broker一扔,拿到响应就给用户返回成功,根本不做持久化校验;消费者拿到消息直接处理,处理完就打ack,失败了就直接丢进垃圾桶,连个重试的逻辑都没有。
别犟。
消息丢了真的不是什么罕见的幺蛾子。Broker宕机了没做持久化会丢,网络抖动消息没发出去会丢,消费端处理到一半重启了也会丢。没有配置持久化、没有重试机制、没有死信队列兜底的消息队列,本质上就是个比本地日志靠谱一点的临时管道,根本撑不起核心业务流程。
之前碰到个做连锁门店收银的团队,把支付成功的消息通过MQ推给库存系统扣减库存,结果因为Broker没开持久化,凌晨机器重启丢了两千多条消息,门店盘库的时候账实差了十几万,查了整整三天才把原因找出来。
很多人觉得“我把acks配置成all不就完了”。哪有这么简单。

消息发出去了,Broker存了,消费者拿到了,但是处理失败了怎么办?总不能让消息直接没了吧。这时候就得有死信队列兜底——所有多次重试都失败的消息,统一丢到死信队列里,后面有专门的程序去排查、去补处理。别等业务出问题了,才发现连个捞消息的地方都找不到。
你看不见的隐形成本
很多人算上MQ的账,只算买服务器、搭集群的那点显性成本,根本没算后面要填的坑要花多少精力。
最常见的坑就是重复消费。
别犟。
网络闪断、消费端超时没及时回ack、Broker触发重平衡,每一个环节都可能把同一条消息送到消费端好几次。如果你的消费端没有做幂等校验,同一条扣款消息重复跑两次,用户的钱就被扣了双份;同一条发货消息重复跑两次,用户能收到两个快递。这种级别的事故,比丢消息还难收拾。

还有消费延迟的问题。你以为MQ是个永动机,消息堆进去就能马上被消费?要是下游服务扛不住,消息能在队列里堆几个小时,甚至几天。你得有监控盯着消费延迟吧?得有告警机制吧?延迟到多少阈值了要通知运维扩容吧?这些东西搭起来,根本不是装个软件就能完事的。
不过话说回来,选MQ的时候也别听那些吹的天花乱坠的选型指南。不是所有场景都要上Kafka,不是所有场景都要追求百万级吞吐量。你要是做业务流程的异步通知,要求路由灵活、延迟低,RabbitMQ用着顺手就别硬凑Kafka的热闹;你要是做海量日志的实时传输,Kafka的吞吐量优势能帮你省一半的服务器成本,那就没必要在RabbitMQ上死磕。
我跑过近二十个技术团队的架构评审,见过太多上来就拍脑袋上MQ的方案。十有八九,最后团队花了好几个月填坑,才发现当初的需求根本不需要MQ。
真要上之前,先问自己三个问题:同步调用的链路真的扛不住峰值了吗?异步之后的业务一致性真的能接受吗?出了问题团队有没有能力排查和兜底?
想清楚了再上。
不然你搭的不是技术架构,是给自己埋的雷。