凌晨两点,订单群里又炸了。测试同学说下单失败,运维说数据库连接池满了,开发说昨天只改了一个优惠券规则。可发布单里躺着三十七个文件。那一刻老周拍了桌子:拆,必须拆微服务。
先别笑。很多团队都是这个状态冲进微服务的。拆完三个月,群里更热闹。超时、重试、消息重复、链路断在网关。问题没少,只是换了形状。
先别问微服务好不好先问哪里疼
单体不是原罪。十个人的团队,业务还在试错,单体就是最快的路径。代码乱?先做模块化。发布慢?先看看流水线卡在哪。微服务真正解决的是独立部署和团队协作边界,顺带才解决扩展性问题。
我们当时做了件笨事。拉出近三个月发布记录,把每个需求改过的代码路径标在地图上。结果很扎眼:优惠券、订单、结算三个模块像麻花一样拧在一起。每次改优惠券,订单和结算都要全量回归。这不是技术问题,是发布节奏被绑死了。
所以判断标准很土:如果一个小改动需要三个团队同时上线,拆。如果只是为了简历好看,别拆。
边界不是想出来的而是吵出来的
微服务边界常被说得玄乎。限界上下文?领域驱动?翻译成人话就是:谁负责这块数据,谁负责这个动作。订单服务写订单库,库存服务写库存库。共享一张表,那就不是微服务,是分布式单体。
我见过按技术分层拆的。Controller 一个服务,Service 一个服务,DAO 一个服务。一次下单,网络跳三次。这不是架构,这是把调用栈拉长给人看。更合理的起点是业务能力:支付、库存、优惠券。但支付里还有退款、对账、渠道适配,一开始可以合在一起。边界会变,别追求一次画对。

有个细节很关键:数据所有权。订单创建要扣库存,怎么办?同步调用库存服务,加超时和重试。但重试可能重复扣。于是要幂等。更稳一点,订单服务本地写一张 outbox 表,再异步发事件。库存服务消费后扣减。这样订单不阻塞,代价是最终一致。用户看到下单成功,库存可能延迟几十毫秒。能不能接受?看业务。卖机票和卖课,答案不一样。
上线之后才知道的坑

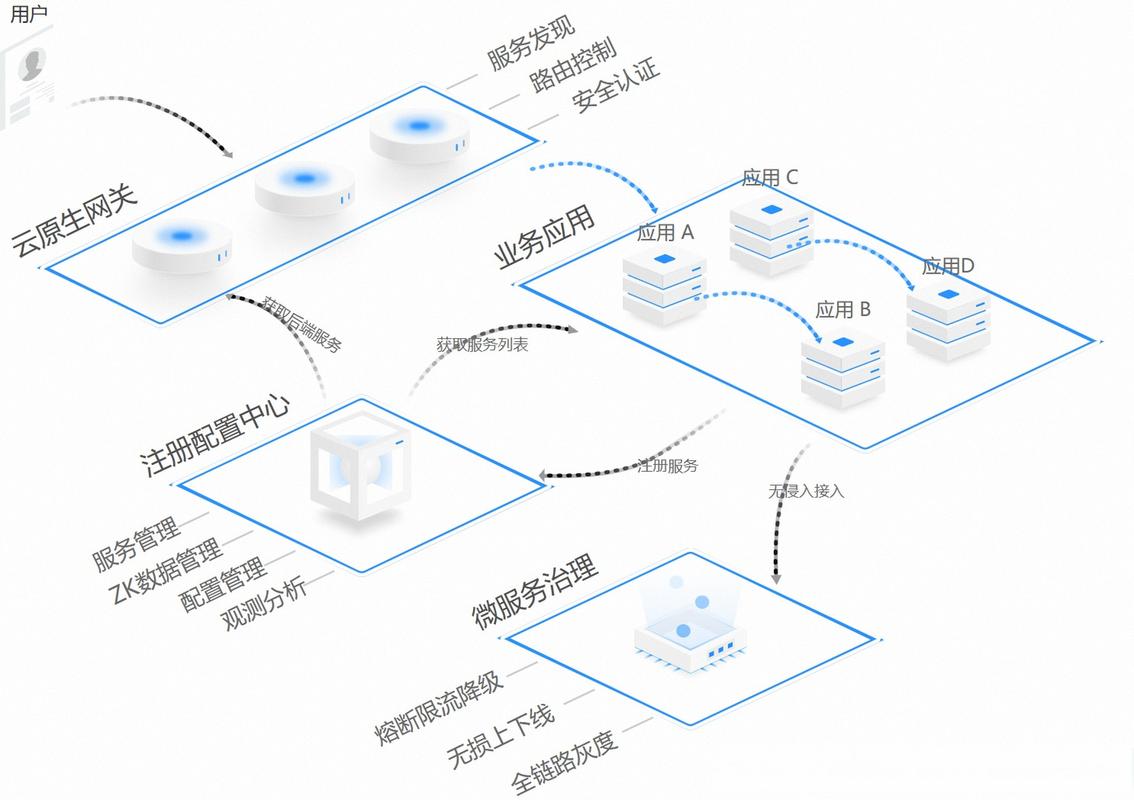
拆完独立发布,大家开心了两周。第三周,一次下单超时。日志散在网关、订单、库存三个服务里。没有 traceId,只能靠时间戳猜。那晚我们干了件正确的事:网关统一生成 traceId,HTTP header 透传,所有服务日志改成 JSON。再上链路追踪。别一上来就服务网格,团队连优雅停机都没做,网格只会多一层黑盒。
监控也别只看 CPU。要盯P99 延迟、错误率、线程池队列、数据库连接数。尤其是重试。重试是魔鬼,没幂等就是灾难。我们后来给每个写接口加了唯一业务键,重复请求直接返回上次结果。限流和熔断也要有,但阈值别拍脑袋。压测一轮,把真实容量写进配置中心。
还有配置。测试环境超时 2 秒,生产 500 毫秒,改错一次就雪崩。配置中心要有版本和审计。回滚预案也得提前写,别等出事再建群。
一份不那么性感的行动清单
如果非要现在动手,我会这么排:
第一,先拆读多写少、变更频繁的模块,比如商品查询、优惠券规则。别先动支付。
第二,接口契约先行。OpenAPI 或 Protobuf 都行,先让上下游能并行。
第三,数据不共享。共享库只读可以,写绝对不行。跨服务查询走 API 或事件。
第四,日志链路和告警先于业务拆分。没有可观测性,拆完就是睁眼瞎。
第五,保留单体兜底。新服务出问题,能切回旧逻辑。别一上来就删代码。
微服务不是目标,是妥协。是组织变大、发布变慢、故障隔离变难之后,拿复杂度换独立性的交易。交易划不划算,得看团队能不能接住。接不住,就先别拆。接得住,也别全拆。拆到刚好能独立发布、独立排障、独立扩容,就够了。
凌晨两点的问题不会消失,但至少下次,你知道该看哪个服务的哪条日志。这比架构图漂亮重要多了。