链路追踪数据采样策略不是配个比例就完事
2026-11-22 02:06:54
作者:
fawen
采样比例一改 整个链路就瞎了
上周有个朋友在群里发了一张图。他们的调用链从入口到下游七个服务,结果只看到三个。问我怎么回事。
我说你采样率调多少。他说1%。
好家伙。
链路追踪采样这件事,很多团队的做法特别粗暴——在Agent里配一个固定比例,比如百分之一、千分之一,然后就觉得完事了。等到排查线上问题的时候发现,出问题的那个请求根本没被采集到。剩下的数据全是正常请求的样本,P99看着漂亮得很。
这就是最典型的采样陷阱。固定比例采样最大的问题不是丢数据,而是丢的都是你需要的那些数据。
反过来想,你留了1%的样本,它能代表全部流量的特征吗?在统计意义上可能勉强可以。但故障不是均匀分布的。一个偶发的超时,可能一万个请求里才出现一次。按1%的比例采,你得有一百万个请求才能勉强捕到一个异常样本。运气不好,一个都留不下。
 分布式追踪链路采样率与数据丢失关系示意图
尾部采样解决了一部分问题 但新的麻烦跟着来了
尾部采样(Tail-based Sampling)这几年讨论得很多。核心思路说白了就是——等请求结束,看看这条Trace发生了什么事,再决定要不要留。
慢请求?留。报错了?留。正常返回、耗时20毫秒?丢了吧。
听起来很美。
麻烦在于,你必须在内存里缓存整条Trace的所有Span,等所有服务都上报完毕,才能做出采样决策。这就带来几个硬性约束。
第一,内存开销。你想想,一个大集群每秒几十万Span在飞,每个都要在Collector里驻留几秒到几十秒……这内存占用不是开玩笑的。
第二,等待窗口怎么定。等太短,慢服务的Span还没到就做决策了,容易误判。等太长,内存扛不住不说,数据延迟也上去了。通常做法是按trace ID做一致性哈希路由到同一个Collector实例,然后设一个10到30秒的窗口。超过就按已有信息决策。
第三……其实第二已经够麻烦了。
还有个容易忽略的事:尾部采样对Collector的可用性要求极高。一旦Collector重启或者扩容,正在缓存里的那些Trace——抱歉,全丢了。你可能刚好丢的就是那个关键的慢请求。
头部采样和尾部采样不是对立的
很多人喜欢做选择题:要么头部,要么尾部。实际生产中更靠谱的做法是组合。
在SDK层做头部采样,用一个相对高的比例,比如20%到50%。先把数据量压下来,但保留足够的样本密度。
然后在Collector层做尾部采样,从这一批里面精挑细选出真正有价值的Trace。
这两个阶段的采样逻辑完全不同。头部阶段你不知道这条请求最终会怎样,只能基于一些先验知识去判断——比如接口名称、请求参数、HTTP Header里携带的调试标记。尾部阶段你已经知道全貌了,可以按错误码、延迟分位数、服务拓扑路径来筛选。
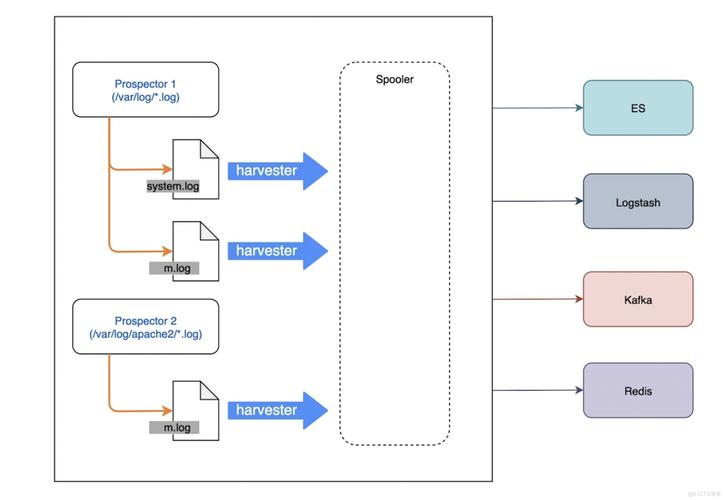 微服务链路追踪两级采样架构流程图
这个架构的代价?你得维护两套采样配置,而且两层的规则需要协调。头部采得太狠,尾部采样再聪明也没用——巧妇难为无米之炊。头部采得太松,尾部那层的计算压力又上去了。
那些生产环境里的实际取舍
说几个具体的例子。
对高频健康检查接口,直接在Agent层做过滤,连Span都不生成。这类请求占总量可能超过一半,留着就是浪费。
对核心交易链路,头部采样率可以给高一点,配合尾部采样兜底。对非核心的异步任务,采样率低一些也没关系,反正出了问题影响面有限。
但这里有个问题——你怎么知道哪个接口是核心的?
很多团队其实说不清。这时候可以反过来做:先跑一段时间的全量采集,用数据告诉你哪些接口的QPS最高、哪些链路最深、哪些Span占比最大。心里有数了再配采样策略。
还有个实操层面的细节:动态调整采样率比静态配置靠谱得多。比如大促期间临时提高核心接口的采样率,流量低谷期再把比例降回来。这需要SDK支持从配置中心实时拉取采样规则,而不是写死在启动参数里。
代价是什么?你需要一套配置管理的机制,需要验证动态生效的逻辑没有bug,需要在压测环境里反复演练。但这些投入比存储账单爆炸之后再回头优化要划算。
最后说一句不那么技术的事
 最后说一句不那么技术的事
采样策略本质上是成本和可观测性之间的博弈。
你想要100%的数据,就得付出100%的存储和计算成本。你只想要10%的数据,就要接受某些问题可能永远看不到。
没有标准答案。只有根据你的业务特点、故障模式、预算约束去不断调整的答案。
但有一点是确定的——如果你从来没认真想过采样策略这件事,那你大概率正在浪费钱,或者在丢失关键数据。可能两者同时发生。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
链路追踪数据采样策略不是配个比例就完事
文章链接:https://m.itcdj.com/news/1013.html