Kubernetes落地里没说透的那些代价
2026-11-03 07:30:20
作者:
fawen
上周跟一个做中小团队运维的朋友吃饭,他吐了半小时苦水。团队12个人,硬上了Kubernetes,现在每周要花15个小时排集群的小故障,业务迭代速度比之前用裸机部署还慢30%。
别拿“行业标配”当决策理由
跟朋友吃饭的时候他说,当初团队拍板上Kubernetes,就是看同行的技术分享里都在吹,说不上就跟不上行业节奏,根本没算过自己的实际需求。
很多人没意识到,Kubernetes的决策从来不是技术问题,是实打实的成本账。你有多少服务,多少并发,多少运维人力,能承受多长的故障恢复时间,这些数算不清楚,光靠“大厂都用”的理由拍板,最后大概率要踩坑。
说白了,这就像你平时上下班开个代步车就行,非要买个重卡,说是行业里搞物流的都用,你也能拉货,结果每次停车都要占三个车位,油耗是之前的五倍,图啥?
什么场景下Kubernetes的价值真的能覆盖成本?大概是你有几十上百个微服务,跨两个以上可用区部署,需要每天做十几次版本迭代,有明确的自动扩缩容需求,团队里至少有一个人能独立处理集群的网络、存储故障。如果你的团队总共就三四个后端服务,每天的总访问量不到一万,那上Kubernetes纯粹是给自己找事。
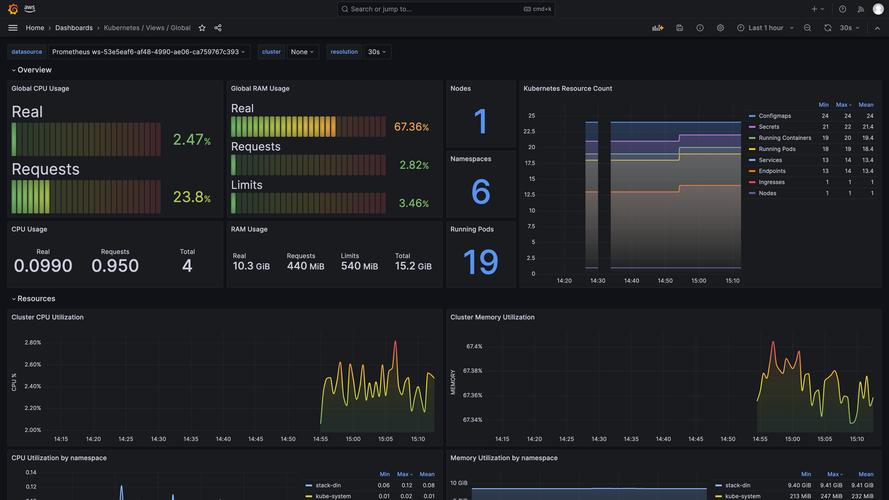 Kubernetes集群节点资源监控 Grafana面板实拍
藏在文档缝隙里的隐性成本
很多人翻完官方的快速入门文档,觉得Kubernetes就是写几个yaml文件,敲个apply命令就能跑起来,根本不知道文档缝隙里藏着多少要花钱花时间的坑。
就拿网络插件选个选项来说。选Calico,你可以做精细的网络策略控制,但是策略规则写错了,整个集群的服务都通不了,排障要翻几十层iptables规则,没个两三个小时根本找不到问题在哪;选Flannel,配置简单跨节点网络打通快,但是跨节点的网络延迟会比本地网络高15%左右,对实时性要求高的交易类业务根本扛不住。
还有存储的选择。用本地存储,Pod漂移到别的节点,之前写在本地磁盘上的数据直接没了,找都找不回来;用云厂商的块存储,每个月的存储成本比之前裸机部署高两倍,还要手动处理磁盘挂载、扩容的流程。
更别说人力成本。现在市面上能把Kubernetes玩明白的工程师,薪资比普通应用运维高40%都不止。你要是想省这个钱,找个刚看完两本入门教程的开发兼职管集群,迟早要出大事。我之前见过一个团队,就是为了省运维成本,让兼职的开发管集群,结果一次证书过期没及时更新,整个集群的所有服务停了4个小时,损失的钱够雇三个资深运维管三年。
 Kubernetes排障时的 kubectl describe 命令行输出实拍
绕不开的取舍没有万能解
 绕不开的取舍没有万能解
不是说Kubernetes不好。任何工具都有适用场景,关键是你要想清楚自己愿意为这些能力付多少代价,别指望有什么完美的解决方案。
很多人说自建集群太麻烦,那就选托管的Kubernetes服务,云厂商帮你维护控制平面,处理节点升级、备份这些杂事,能省大概60%的运维工作量。但问题是,托管服务的隐性绑定成本从来没人跟你算透。厂商给你把控制平面维护好,把升级流程做顺,看起来省了不少事,但你所有的集群配置、网络策略、存储挂载,全都是跟这家厂商的API绑定的,哪天你想换个云厂商,光迁移集群的工作量,就够你整个团队忙一个月。之前有个朋友的团队就是用了某家的托管Kubernetes,去年厂商调整了网络插件的默认配置,他们的集群直接断了半个多小时,连厂商的客服都给不出快速回滚的方案,只能干等着。
还有人追求全套的云原生技术栈,什么服务网格、Serverless、GitOps全往集群里堆,觉得栈越全越先进。结果栈叠得越来越厚,出了问题根本不知道是哪一层的锅。
yaml文件里的每一行配置,都是埋着的小坑。你给容器设的CPU request值比实际需求低30%,节点上的kubelet就会在资源紧张的时候给你的容器限流,用户点个按钮转三圈才能加载出来;你把Pod的反亲和规则写错了,所有副本全挤在同一个节点上,这个节点一断电,整个服务直接挂掉。这些细节,官方文档只会告诉你参数是什么意思,不会告诉你踩坑之后要花几个小时排障。
上周跟那个吐槽的朋友再见面,他已经把集群里一半的非核心服务迁回了原来的裸机部署,只把需要频繁迭代的电商核心服务留在Kubernetes上。现在每周的排障时间降到了3个小时,业务迭代速度反而快了。
这事没那么玄。
工具永远是解决问题的,不是拿来当身份标签的。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
Kubernetes落地里没说透的那些代价
文章链接:https://m.itcdj.com/it/418.html