上个月帮做电商的朋友排查线上慢SQL,他说自己给所有查询涉及的字段都加了索引,结果写入接口卡到用户付不了款,整个服务的超时率飙到30%。
这事没那么玄。
很多人对数据库索引的认知,从一开始就偏了。
你以为的索引,和实际跑在磁盘上的根本不是一回事
刚入行的开发对索引的印象,基本都来自入门教程里那句“加了索引查询就快”。没人提过索引到底在磁盘上是怎么存的,也没人算过你为了这份“快”,到底要付出什么代价。
说白了,数据库索引本质是把无序的行数据,按照某几个字段的排序规则,单独存成一份平衡树结构。查的时候不用把整个磁盘上的表从头扫到尾,顺着树的节点一层一层往下找,几次IO就能定位到目标行。

每多建一个索引,就相当于多存一份需要同步维护的排序数据副本。
你每次执行insert、update、delete的时候,数据库不能只改主表的那几行数据,还要同步把所有相关索引树里的对应节点更新掉。这可不是什么零成本的操作。
我见过最夸张的表,1200万行的用户订单表,上面建了11个单值索引。每次插入一条新订单,除了写主表,要在11棵不同的索引树里找位置插节点,碰到节点页满了还要做页分裂,写一条数据的时间,比没有任何索引的表多了整整4倍。
最容易踩的坑,从来不是没加索引
每次慢查询排查会上,总有开发拍桌子说“这个SQL没走索引!赶紧给相关字段加一个!”
大部分时候,根本不是没加索引的问题。
是你加的索引,从一开始就没打算被用上。
比如给字符串类型的用户ID建了索引,查询的时候偏要写where user_id = 123,把字符串当数字传,数据库直接做隐式类型转换,索引直接失效。还有那种花了半天时间建的联合索引,(user_id, create_time)的组合,查询的时候只写where create_time = ‘2024-01-01’,最左匹配原则直接卡壳,索引白建。
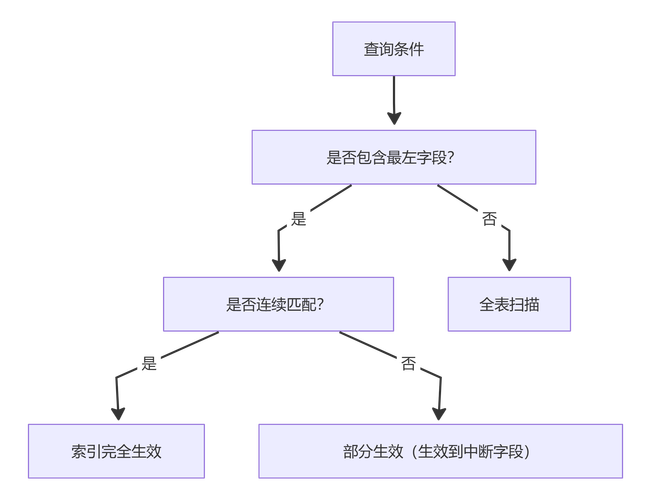
说实话,每次碰到这种情况,我都替他浪费的磁盘空间心疼。一个亿级表的联合索引,占的存储差不多是主表的三分之一,白存了不说,每次写入还要花CPU和IO去维护,纯纯的线上负资产。
别觉得这种事离你很远。我之前翻某创业公司的线上库,发现有个表上建的6个索引,有4个从上线到被删,从来没被任何一条查询SQL命中过。纯粹是之前的开发图省事,见着where后面的字段就加索引,根本没去看过实际的查询逻辑。
索引的本质是一笔算得清的交易

很多人找我问索引优化的问题,上来就说“我这个表慢,应该建什么索引?”
我第一反应都是反问:你这个表的读写比例是多少?日常的查询都是哪些条件?
所有脱离读写比例谈索引优化的建议,都是站着说话不腰疼。
读多写少的用户画像表,你建三四个甚至五六个贴合查询场景的联合索引都没关系。毕竟写入频率低,每次查询省下来的时间,远大于维护索引的成本。但如果是那种实时的交易流水表,每秒要写入几千条数据,你还乱建一堆单值索引,那就是拿线上稳定性开玩笑。
之前在技术沙龙上碰到个做支付的工程师,他们的交易表因为早期开发乱建了8个单值索引,导致每笔交易的写入延迟从10ms涨到了80ms,高峰期甚至会出现写入堆积。后来花了两周时间把没用的索引全删掉,只留了两个覆盖核心查询场景的联合索引,写入延迟直接降回原来的水平。
读性能?根本没受影响。
因为之前那8个索引里,有5个从建完那天起,就没被任何SQL用到过。
没什么魔法。
很多人把数据库索引当成什么一劳永逸的性能优化工具,觉得加了就能高枕无忧。实际上它更像你家里的储物柜,你为了找东西方便,给每类物品贴标签、分格子,但如果一半的格子从来没放过东西,你每次整理柜子的时候还要花时间擦这些空格子、重新贴标签,这就完全没必要了。