数据库慢查询定位与优化实战手记
2026-11-01 23:01:35
作者:
fawen
上周凌晨两点被电话炸醒。
是前公司运维的小周,声音都发颤。说大促预演的时候,运营拉30天的订单汇总报表,数据库直接卡到连后台登录都转圈。
我套上外套连了VPN上去,第一反应不是找SQL哪里错了,是先跑show processlist把所有正在跑的会话列出来。
真遇上慢查询,没人能稳得住。
先别急着改SQL,先把慢的证据抓全
很多人一看到慢查询告警,冲上去就对着SQL改,加where条件,改join顺序,折腾半天发现根本找错了方向。
慢查询定位的第一步永远不是猜,是把执行计划和实际执行耗时拆解开。
我上去先把那个跑了快一分钟的慢查询捞出来,先看它的执行计划。小周在旁边急得挠头,说上周刚给这个表加了三个索引,怎么还慢。
结果执行计划一拉出来,rows字段显示要扫180多万行,Extra里明明白白写着Using temporary; Using filesort。
 MySQL慢查询日志输出示例截图
说实话,我当时看到这俩提示就知道,问题根本不在有没有索引。是查询本身的逻辑写得有问题,导致索引全白搭。
之前见过太多人看执行计划只盯着type是不是ALL,觉得只要不是全表扫描就万事大吉。真遇到复杂业务SQL,这种判断十有八九要踩坑。你得看filtered字段,看临时表是在内存还是磁盘,看回表的次数有多少——这些细碎的指标,才是真正决定查询跑多久的核心。
那些看起来“写对了”的SQL,藏着多少坑
把SQL原文拉出来一看,我差点气笑。
开发写的是left join订单表和用户表,本来的逻辑是要保留所有订单记录,哪怕是没关联到有效用户的游客订单。结果他为了筛掉无效的测试用户,把u.status=1的过滤条件写在了where子句里。
这一下直接把left join的逻辑变成了inner join不说,还因为这个条件的位置不对,导致本来能用的联合索引直接失效。
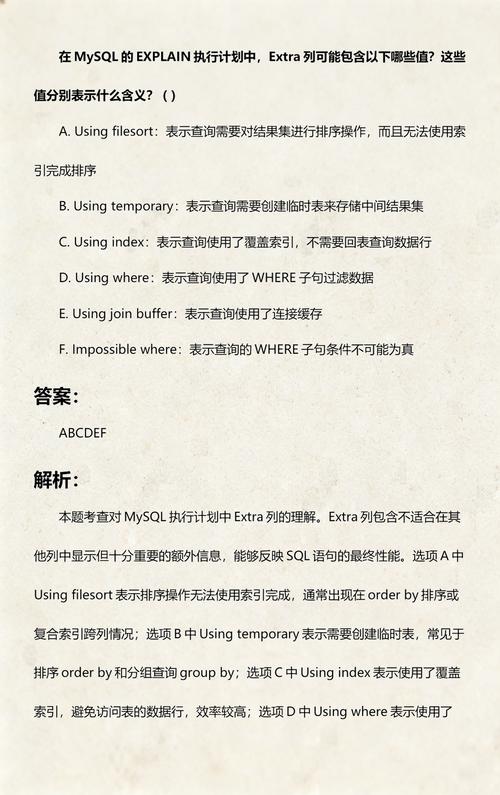 MySQL执行计划Extra字段含义对照表
更坑的是,这个查询要拉的字段里,包含了用户的昵称、等级这些不在索引里的字段。本来走索引回表也能接受,结果因为要排序的字段不在索引顺序里,数据库直接生成了一个磁盘上的临时表,把180万行数据先写进去,再排序汇总。那速度能快才怪。
索引不是建了就有用,查询条件的顺序、位置错了,再好的索引也是摆设。
小周在旁边翻之前的优化记录,说去年大促前特意给这俩表建了三个联合索引,花了快两个小时把表锁了重建,合着全给这破SQL当垫脚石了。
优化完别着急上线,得算清楚性价比
换别人可能上来就改SQL,把status的条件挪到join的on子句里,再调整下联合索引的字段顺序,让排序和过滤都能走索引。我之前也这么干过,结果上次为了优化一个运营报表,把核心订单表的写入性能干下去20%,大促当天的支付接口卡了三次,被业务部门追着骂了一周。
这次我们换了个思路。
这个报表本来就是运营每天早上看的,根本不需要实时查询。我们干脆把这个慢查询整个挪到了只读从库上,又把原来的大查询拆成了三步:先按时间范围从主表捞符合条件的订单id,再批量查关联的用户信息,最后在应用层做数据汇总。
改完之后跑了一遍,原来要47秒的查询,现在8秒就出结果。核心主库的写入性能一点没受影响。
不过话说回来,很多团队总追求极致的查询速度,根本不算背后的成本。为了一个每天跑一次的报表,把核心交易链路的写入稳定性搞崩,这账怎么算都亏。
那天改完已经凌晨三点,运营的小姐姐在群里发消息,说刚才还准备泡碗面等报表出来,结果眨眼就加载完了。
我关了电脑躺回床上的时候就在想。
做数据库优化这么多年,从来没有什么银弹。
你以为的慢查询,很多时候根本不是数据库的问题。是写SQL的人没搞懂业务逻辑,是做优化的人没算清成本,是团队总想着用技术手段补流程的窟窿。
下次再遇到慢查询告警,先别急着冲上去加索引。
先把现场看明白。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
数据库慢查询定位与优化实战手记
文章链接:https://m.itcdj.com/it/375.html