监控告警不该是团队的无效噪音
2026-11-01 16:14:09
作者:
fawen
上周三凌晨两点十七分,我手机弹了条微信。是阿凯,在雨花台区做本地生活系统运维的老伙计。内容只有三个字:“想杀人。”
等他爬起来连完VPN查完所有日志才发现,那条把他从床上炸起来的最高级告警,是测试环境的Redis内存比阈值多飘了0.2G。跟线上业务半毛钱关系没有。他说当时盯着屏幕,连砸键盘的力气都没了。
告警泛滥是怎么把人搞麻木的
太多团队对监控告警的理解,从一开始就歪了。
总觉得接的指标越多,系统就越安全。CPU超10%要报警,磁盘剩15%要报警,甚至Nginx日志里多了几条404都要@全群。
算过账吗?
一天327条告警,299条都是无关痛痒的阈值飘移。换你你能每条都逐字看完?别吹什么职业素养。人的注意力是有额度的,连续被无关信息轰炸半个月,再看到告警弹窗的时候,第一反应不是“是不是出问题了”,而是“这又是哪条破规则乱弹的”。
 运维深夜接告警电话的真实场景
我见过最离谱的团队,告警群直接设置成了永久免打扰。上次核心服务崩了,整整22分钟没人看到告警,等客服接到用户投诉反馈过来的时候,首页已经打不开了。
你说怪谁?怪值班的人责任心不够?真的不怪。换你天天被无效信息磨,你也麻。
别拿阈值当万能解药
很多人搞监控,上来就拍脑袋定阈值。
CPU超过70%报警,响应时间超过200ms报警,内存使用率超过80%报警。
从来不想这些阈值定得合理吗?跟真实的业务影响挂钩吗?
之前接触过一个做生鲜电商的团队,去年618大促的时候,把订单接口的响应时间阈值设成了200ms。结果峰值流量上来,正常的波动就比阈值高了30ms,半小时弹了412条告警。最后值班的人实在烦得不行,直接把这条规则关了。
巧的是关完不到2小时,数据库连接池打满,真实的订单接口超时了。因为规则被关,根本没触发告警,等发现的时候,已经有1200多个用户付了钱看不到订单。算下来直接损失快30万。
所有脱离业务影响的告警阈值,本质都是在给团队制造无效工作。
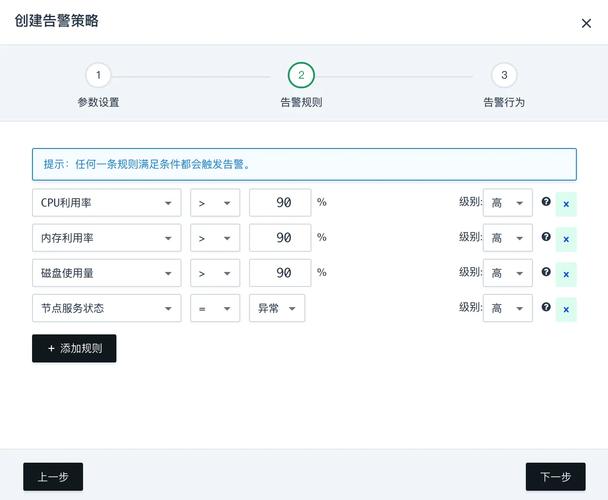 电商大促期间告警规则配置后台截图
更别说那些连基本降噪都不做的规则了。同一个机房的三个实例同时因为交换机端口抖动飘了CPU,本来合并成一条告警说清楚是网络问题就完了,非要拆成三条分别@三个值班人,大家爬起来折腾半小时,最后发现跟自己管的应用半毛钱关系没有。
说实话,我见过最扯的一条告警,是某个团队给代码仓库设的:当天提交代码数不足10条,就要@技术负责人。这哪是监控告警,这是变相盯考勤呢对吧。
真能用的告警从来不是越多越好
阿凯他们团队今年年初做了一次告警规则大清理。
之前312条规则,砍到剩27条。
怎么砍的?
把所有不直接影响用户体验、不影响营收的告警全删了。什么测试环境的资源飘高、内部OA的页面加载慢、开发机的磁盘满了,这些东西根本没必要触发高级告警,最多在内部的运维看板上展示一下就行。
然后剩下的规则,全部加了上下文。之前的告警只写“CPU使用率92%”,现在直接把关联的服务名、过去1小时的流量曲线、最近的发版记录、甚至对应的错误日志链接全附在告警内容里,值班的人点开就能看到前因后果,不用再自己登三四个系统查背景。
最关键的是,他们改了告警的触发逻辑:只有当连续3分钟订单接口的错误率超过1%,且影响的真实用户数超过50个的时候,才会触发最高级别的电话告警。其他的指标波动,只要不影响真实用户下单,就只发个普通的群消息,不打任何人的电话。
就这么改完,他们团队值班半夜接电话的次数直接降了82%。上个月支付通道出了点小故障,所有人第一时间收到了电话,11分钟就切到了备用通道,连大部分用户都没感知到异常。
别总追求什么监控覆盖率100%。你把所有能想到的指标都接进系统,最后得到的只是一堆没人看的垃圾数据。你一个内部用的报销系统,至于把每个页面的加载时间都设成告警吗?加载慢个几秒,谁会真的在意啊。
上周跟阿凯在软件大道吃鸭血粉丝汤,他说现在终于敢把手机放床头柜上睡觉了。不用攥在手里等那些毫无意义的电话。
你看,好的监控告警本来就该是这样。不是为了把人24小时绑在告警线上,是真的出问题的时候,能第一时间帮你把问题捞出来,没出问题的时候,就安安静静待在系统里,别出来打扰人。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
监控告警不该是团队的无效噪音
文章链接:https://m.itcdj.com/it/365.html