上周跟一个做了6年运维的老同事吃饭,他第一句话就是,早知道当初不上Kubernetes,现在能少掉三分之一的头发。
谁没在凌晨三点收到过K8s的告警短信啊,爬起来连VPN登服务器,查了半小时发现是某个开发的测试Pod占满了磁盘,那瞬间的火气,真的想把整个集群删了。
先把神坛上的K8s拉下来
说白了,很多人当初选K8s,都是听了社区的宣传,什么自动扩缩容,什么服务发现,什么滚动更新,听着全是优点。真上了才发现,你要先养一个能跑起来的集群,成本比你想象的高10倍都不止。
不是装完kubeadm就完事了。
你得提前算好每个节点的配置够不够,etcd要不要单独拆出来跑,网络插件选Calico还是Flannel,存储类怎么对接现有的分布式存储,哪一个环节没踩明白,半夜报警能把你从床上薅起来。
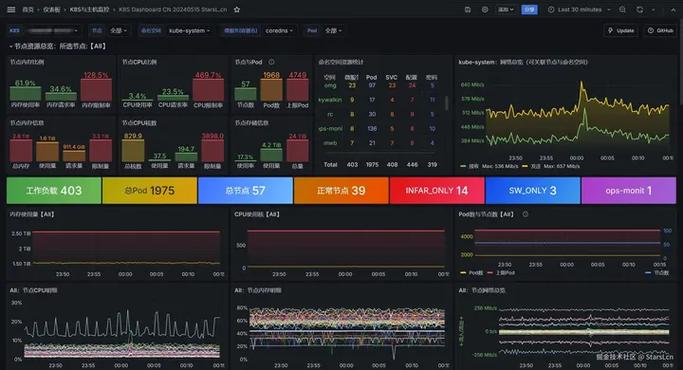
很多中小团队的误区,就是觉得上了K8s就能省人力。其实反过来,你没有个能把K8s玩明白的核心运维,光靠网上抄的部署脚本,跑个测试环境还行,真扛线上业务,分分钟出问题。之前接触过一个做电商的小团队,3个开发凑钱搭了个K8s集群,大促的时候流量涨了3倍,自动扩缩容是开了,结果节点CPU直接打满,整个集群因为资源抢占进入死锁,半小时没下单入口,损失的钱够养三个专职运维两年。
那些藏在文档里的隐形成本
麻烦在于,K8s的官方文档写的都是“最佳实践”,但从来不会告诉你,这些实践背后要付多少代价。
很多人吹的声明式API,用久了才知道,你写的YAML多一个空格,少一个缩进,整个应用直接起不来。
没人天生会写YAML。
你得给每个开发做培训,教他们怎么写Deployment,怎么配资源请求和限制,怎么排查Service的转发规则,光这一套培训下来,前三个月的开发效率至少掉两成。
还有监控的成本,你不能光靠K8s自带的组件,你得搭Prometheus,得配Alertmanager,得给每个核心指标设告警阈值,不然节点挂了你都不知道。

版本迭代的坑更烦。K8s每三个月一个小版本,一年四个发布周期,你要是一直停在两年前的版本,社区的安全补丁都不更了,被打穿了都不知道;你要是追新,新版本的API变更,可能你之前写的一堆YAML直接失效,升级一次集群,要测一周,出问题回滚都要半天。说实话,很多团队根本没精力做持续的版本升级,最后就是集群跑在一个没人敢碰的老版本上,跟个定时炸弹似的。
不上K8s难道就不行?
当然不是。
这事没那么玄。
我见过很多团队,用docker compose跑十几个微服务,配个简单的负载均衡,靠脚本做滚动更新,一年下来出的故障,比那些硬上K8s的团队少一半,运维的精力还能省下来做业务优化。
取舍的核心从来不是技术先进不先进,是你的团队规模、业务体量,能不能扛得住这个技术的维护成本。比如你团队就5个人,业务流量一天也就几千PV,你非要搭个三节点的K8s集群,光集群本身占的资源,够你跑现在所有业务两遍,纯属浪费。
很多人觉得K8s是未来的趋势,现在不上以后要落后。其实真到你业务长到几百个服务,流量峰值百万级的时候,你再上也完全来得及,到时候你对业务的理解,对运维流程的沉淀,比你现在硬抄社区的最佳实践靠谱多了。
上周那个老同事最后说,现在他们把集群缩成了两个节点,把不必要的功能全砍了,每天下班能准点走,比啥都强。对了,他最近在给团队写简化版的K8s操作手册,就三页纸,多一个字都不写。