上周在雨花台创业园楼下的皮肚面店,做电商中后台的哥们拍着油汪汪的桌子骂娘。说上周公司硬卡单元测试覆盖率到75%,他们组四个人熬了两个大夜,对着业务代码瞎写测试,硬凑到82%。结果周三上线的订单拆分逻辑,直接漏了满减叠加的边界情况,赔了小二十万的优惠券。
没用的。
这种凑出来的覆盖率,本质上就是自欺欺人。
你拿到的覆盖率数字 大概率掺了水
很多团队对覆盖率的认知,还停留在”代码跑过就算数”的阶段。就像刚才那哥们的组,他们写的测试用例,一半都是给getter、setter写的——就是传个值进去,断言返回值和传入值一样,这种测试除了凑行数,半毛钱用都没有。
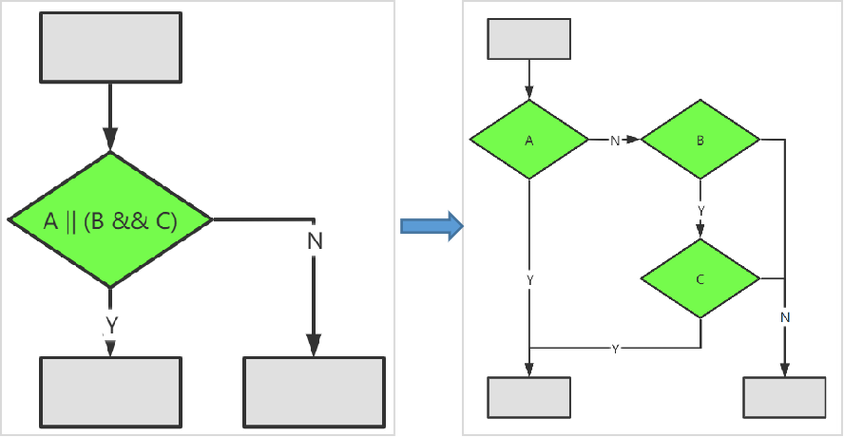
更常见的操作是,对着一个多分支的业务方法,只传一个正常参数跑通主流程,行覆盖看起来是100%,但实际上那些异常分支、边界条件的代码,根本没被触发过。
就拿他们出问题的订单金额计算方法来说,里面有三个独立分支:普通商品、满减叠加、折扣叠加。他们只写了普通商品的测试用例,整个方法的代码都执行了一遍,行覆盖拉满,但满减的逻辑根本没测,出问题是早晚的事。
说实话,我见过太多团队为了应付考核,对着覆盖率工具的数字瞎折腾。要么把测试用例写得全是断言恒真的废代码,要么干脆把核心业务的代码排除在覆盖率统计之外——反正数字好看就行,真出了故障,没人会去翻你之前的覆盖率报告。
别上来就啃老代码 先从增量部分下手
为啥大家提升覆盖率这么痛苦?90%的原因是一上来就给整个仓库的覆盖率定目标。
你想想,一个跑了五六年的老业务仓库,几万行没人维护的代码,连写代码的人都离职了,你让新来的同学对着这些代码补测试?别说补测试了,能看懂逻辑就不错了。最后大家只能挑最没技术含量的工具类、CRUD接口写测试,凑够数就完事,核心业务的漏洞该有还是有。
正确的思路根本不是追着老代码补测试,而是先把增量覆盖率门禁配上。简单说就是,所有新提交的代码,必须达到约定的覆盖率标准,才能合并到主干。核心交易链路的新代码,分支覆盖至少要到80%,普通工具类到70%就行,非核心的运营后台代码,到60%就够。
刚才那哥们的团队后来改了规则,不再要求整个仓库的覆盖率,只卡新提交的代码。不到一个月,他们新写的订单模块覆盖率自然涨到了83%,而且全是针对真实业务逻辑写的测试,再也没有那种凑数的getter测试了。
不用熬夜,不用啃老代码,新代码写的时候顺手把测试补了,覆盖率自然就上来了。
这些偷懒技巧 能帮你少写一半测试
很多人觉得写测试麻烦,是因为还在手动一个个写用例。其实现在的工具已经能帮你省很多事了。
比如写参数化的测试用例,别一个边界情况写一个测试方法。Java用JUnit5的@ParameterizedTest,Python用pytest的@parametrize,把所有的边界情况列成表格,自动就能生成对应的测试用例,改逻辑的时候只要改表格就行,不用挨个找测试方法。
还有更懒的办法,用属性测试。就是你给方法定义好输入输出的规则,工具会自动生成成千上万组随机参数去跑,只要有一组不符合规则,测试就会报错。比如你写了一个计算订单金额的方法,只要定义好”不管传什么参数,返回的金额都不能是负数””满减后的金额不能低于商品总价的10%”这种规则,工具自动帮你测所有的边界情况,根本不用你自己想测试用例。
对了,还有个坑别踩:别什么依赖都mock。我之前见过有人写个测试,mock了七层内部服务,最后跑通了,但是业务逻辑改了之后测试根本不会报错——因为所有的返回值都是你自己写死的,测了个寂寞。只mock外部的第三方接口,比如支付网关、物流查询的接口,内部的服务能跑真实逻辑就跑真实逻辑,不然写的测试全是空中楼阁。
不过话说回来,也别为了追求覆盖率走到另一个极端。
不是所有的代码都需要100%的覆盖率。比如那种纯展示的运营页面的代码,就算出了bug,最多就是个样式不对,影响不大,没必要花时间写测试。把精力花在那些出一次bug就能造成几万、几十万损失的核心逻辑上,比把所有代码都凑到100%覆盖有用得多。
真的,别被那些覆盖率的数字绑架了。测试的目的是帮你少出线上故障,不是为了凑个好看的数字给领导看。