上周跟河西那家做生鲜电商的运维王哥,在软件大道附近的大排档啃龙虾。冰啤酒刚喝到第二杯,他就把烟按灭在装龙虾壳的塑料碗里,开始倒苦水。
去年公司花了小几十万,上了套头部厂商的AIOps平台。本来想解决告警轰炸的老毛病,结果现在那套系统还在服务器上吃灰——除了每月厂商过来收服务费的时候,大家才会点开界面看一眼。
谁懂啊。他们团队总共6个运维,之前大促前压测,一天能收2000多条告警,90%都是重复的。某个交换机端口闪断,能同时触发网络层、服务器层、应用层三个方向的告警,值班的人翻半小时聊天记录,才能找到真正的根因。上次大促有个订单支付接口超时,愣是因为告警被埋在一堆重复的端口提示里,晚了12分钟才响应,算下来丢了快20万的销售额,老板当场拍板要上智能运维,说要把人从告警堆里捞出来。
别把告警收敛当AIOps的全部
很多团队对AIOps的第一认知,就是把刷屏的告警合并成几条,让值班的人不用一晚上盯着手机震到麻。说实话,这确实是AIOps最基础的功能,但也就值整个系统价值的20%。
之前王哥他们刚开始用那套商业平台的时候,确实觉得清爽——原来2000条告警,收敛完一天剩200多条。可没高兴两周就发现问题:收敛后的告警里,还是分不清哪个是真的会影响用户的故障,哪个只是无关紧要的小抖动。上次有个CDN节点的带宽抖动,平台直接给归成了”网络类通用告警”,没人重视,最后导致华东区域的用户刷商品页卡了20分钟。

说白了,告警关联收敛只是把散落的告警归到同一个事件组里,真正能省时间的,是系统能顺着链路把根因指出来——比如这个支付接口超时,到底是数据库慢查询了,还是缓存击穿了,还是网关的配置错了。如果只是把一堆告警凑在一起,那跟之前人工翻聊天记录有啥区别?
别拿大厂的成熟配置硬套小团队
王哥后来跟厂商的实施工程师聊透了才知道,那套平台的模型配置,是照着阿里、京东那种几百人运维团队的场景调的。人家有专门的团队给历史告警打标签,每一条告警都标清楚对应的业务线、故障等级、影响范围,模型学了几十万条标注好的历史数据,当然能精准定位根因。
可他们呢?连过去半年的历史告警标签都没补全,一半的告警记录连是哪个业务系统触发的都没写清楚。你让模型拿啥学?总不能凭空给你变出根因定位的能力吧。
说句不好听的,你自己都理不清的问题,指望买个软件就能自动给你理明白?哪有这种好事。
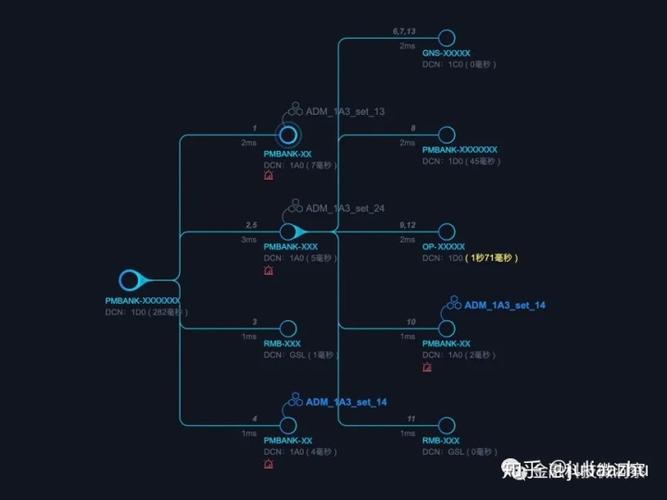
我之前接触过南京本地另一家做企业SaaS的小团队,总共3个运维,监控的服务器加起来才120多台。他们没买那种动辄几十万的商业AIOps平台,就用开源的Prometheus加了个轻量的异常检测插件,先把最核心的三个核心业务链路的告警做了关联——只要订单接口出现超时,系统自动把对应的数据库、缓存、网关的告警拉到同一个事件组里,连带着把最近5分钟的指标波动图附在后面。就这一步,直接把值班的故障响应时间从原来的15分钟,压到了2分钟。前后花的成本,还不到之前商业方案的十分之一。
落地先抓最痛的那一个点

很多人对AIOps的期待太高了,一上来就想搞全栈智能:要能自动检测异常,要能自动定位根因,要能自动执行故障自愈,最好连复盘报告都能自动生成。可现实是,大部分中小团队连最基础的监控数据都没打通,谈什么自动操作?
我见过最离谱的一个团队,刚上AIOps三个月,就着急把自动故障自愈的权限开了。结果赶上促销流量涨了30%,模型把扩容的阈值设错了,硬生生给用户侧的集群扩了3倍的资源,多花了十几万的云成本。最后整个运维团队写了三天的复盘报告,把所有自动操作的权限全关了,说还是人来操作靠谱。
其实真不用这么急。你现在最痛的点是什么?是告警太多刷不完,那就先做告警关联收敛;是每次算资源量都要拍脑袋,那就先做个简单的资源使用趋势预测,能帮你算出下个月数据库的CPU会不会到预警阈值就行。别一上来就想搞个大新闻,把所有功能全堆上去,最后哪个功能都用不好。
前几天王哥给我发消息,说他们把原来那套商业平台的高级功能全关了,就留了个最基础的告警关联模块。整个团队花了一周时间,把过去半年的历史告警标签全补完,现在每天的告警量从2000多条降到了不到100条。上周大促值班,他居然能在工位上眯着睡了两个小时,没被短信震醒。
其实哪有什么神乎其神的AIOps啊。
不过是把之前人要花半小时整理的重复告警,让机器先筛一遍,把人从无意义的重复劳动里捞出来而已。
对吧。