上周帮朋友排查线上故障,用户付完款刷新页面,库存还显示原来的数。查了半天才捋明白,是缓存值没及时更新,和数据库对不上。
被吹烂的延迟双删,真不是万能药
最开始学缓存的时候,所有人都告诉你用延迟双删。先更数据库,再删缓存,等个几百毫秒再删一次。听着完美对吧?
麻烦在于那个“等一会”到底是多久?没人能给你准数。你压测的时候请求量稀稀拉拉,1秒的延迟足够覆盖所有回写场景。真到大促流量峰值,主从同步延迟都能飙到3秒以上,你那设置的200ms延迟,删了等于白给。旧的写请求慢悠悠走完数据库流程,转头就把旧值又塞回缓存里,你第二次删的时候,缓存早又是新的旧值了。
我见过太多人,把网上抄的博客当圣经,连场景都不看就往生产上扔,最后出了问题才到处搜解决方案。真的,别迷信那个所谓的经验值。你生产环境的请求量、数据库性能、主从延迟,和别人的环境半毛钱关系都没有。
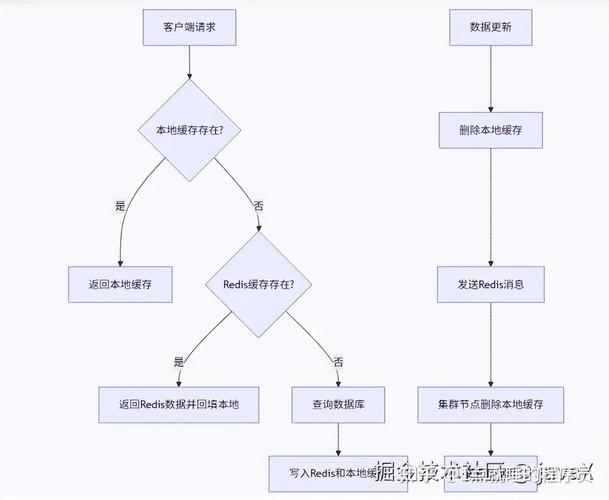
说白了,分布式缓存一致性保障的第一原则,就是别拿通用方案套所有场景。你要是做的是用户头像、公开文章这类非核心内容,缓存过期时间设1小时都没人在意。要是做的是库存、账户余额这类和钱挂钩的场景,你就得反复掂量,到底要在一致性上花多少成本。
别上来就追求强一致,先算清楚你要付的代价
好多架构师一开口就要强一致,要缓存和数据库时时刻刻分毫不差。怎么做到?每次写请求都同步写库、写缓存,两个操作都成功了才给用户返回成功?那缓存的意义在哪?本来缓存就是为了挡读流量、扛高并发、减少数据库压力的,你搞成同步双写,接口延迟直接翻几倍,QPS掉一半,流量上来的时候第一个骂的就是你。
之前接触过一个团队,为了保证库存强一致,每次扣库存都要等主库数据同步到所有从库,再删完所有机房的缓存才返回。结果大促当天,接口平均延迟从20ms涨到320ms,直接把网关的线程池打满,近一半用户提交不了订单。事后复盘才发现,他们为了追求那不到100毫秒的一致性,付出了几十倍的性能代价,完全得不偿失。
这里的取舍其实特别简单。先算清楚你的业务能容忍多久的不一致?1秒?5分钟?还是1小时?能容忍的时间越长,你要付出的系统成本就越低。要是你能容忍10秒的不一致,那给缓存设个合理的过期时间,再加个异步删缓存的逻辑,足够应付绝大多数场景。非要追求毫秒级的强一致,那你还不如直接查数据库,别费那劲搭缓存了,对吧?
没人说的边角场景,才是真的藏雷的地方
大家都知道的主流程坑,踩过一次就记住了。那些没人写在教程里的边角场景,才是真的要命。
比如你用消息队列发删缓存的消息,万一消息丢了怎么办?或者消费失败了,等你重试的时候,缓存已经被别的请求写入了新值,你这时候傻乎乎把新值删了,是不是又引发了一轮缓存击穿?还有缓存击穿的时候,那个拿着旧数据去数据库查的请求,会不会在你删缓存之后,把旧值又原封不动写回缓存里?
更别说多机房部署的情况。你在上海机房写了数据库,删了上海机房的缓存,结果广州机房的缓存还是三天前的旧数据,用户请求被CDN路由到广州节点,看到的旧价格直接下单,投诉分分钟打爆客服。
真的,这些场景,你看十篇入门教程都不一定能碰到,只有自己线上踩过一次,才知道疼。分布式缓存一致性保障从来不是靠某一个神奇的银弹方案搞定的,是靠一点点把这些边角漏洞补上的。比如发删缓存消息的时候带个版本号,只有消息里的版本比当前缓存的版本旧,才不执行删除操作。比如缓存击穿的时候加个互斥锁,只放一个请求去查数据库,从根源上避免旧值回写。这些都是很小的改动,但是能挡掉90%的奇怪故障。
上次那个朋友的故障,最后也没搞什么高大上的方案。就是把库存缓存的过期时间从10分钟改成了1分钟,再加了个订单支付成功后的主动删缓存逻辑,小流量跑了一周,没再出过问题。
没人能拍胸脯说自己的方案100%完美。适合自己业务容忍度的,就是最好的。