上个月在软件大道的鸭血粉丝汤店碰到老周,他扒拉着粉丝,眉头皱得能夹碎卤蛋。他是做垂直电商的技术负责人,上个月618大促当天,网站卡了40分钟。所有监控面板全绿。CPU不高,内存够,接口成功率99.99%。
邪门不?
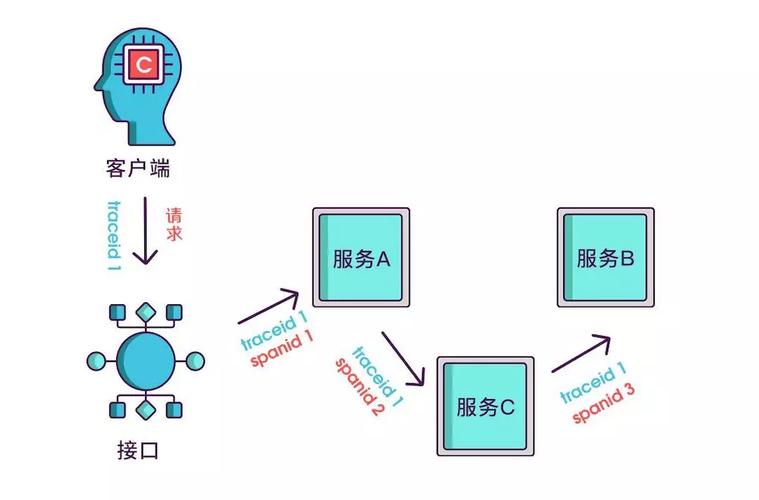
最后折腾到凌晨三点,才发现是新上的灰度网关把跨服务调用的trace上下文头给过滤了,整个支付链路的请求在跳转到第三个服务的时候,就成了没根的孤魂野鬼。监控压根没设这个检测项,自然连个告警都没发。
你以为的监控,其实只是事后验尸
老周他们之前搭的监控体系,说穿了就是把大家都知道要测的指标全摆到面板上——CPU使用率、内存占用、接口响应时间、错误率。阈值设好,到点就发告警。这套东西用了三年,平时小问题确实能兜住。
但它的天生短板就是,你没预设到的问题,它永远不会提醒你。
你知道要测支付接口的成功率,所以你盯着那个数。但你想不到新上线的网关会偷偷把上下文头滤掉,想不到某个缓存节点的时钟飘了3分钟导致所有签名校验失败,想不到某个消息队列的消息因为序列化格式错了,悄悄丢了2%的订单数据。
这些问题,全是监控覆盖不到的盲区。
太冤了。40分钟的故障,算下来直接损失的GMV就有七位数,更别说堆了几百条的客诉。老周说他那天看着满屏全绿的监控面板,第一次觉得之前花几十万搭的监控系统,像个只会按预设台词报幕的木偶。
可观测性的核心,从来不是堆工具
从去年开始,老周团队也在补可观测性的课。一开始走了不少弯路——买了最贵的APM工具,接了开源的日志系统,把链路追踪的SDK全埋到了每个服务里,光搭这套平台就花了三个月。
结果呢?找问题的时候还是要在三个系统之间来回切:看到指标掉了,去日志系统搜对应的错误码,再复制traceID到链路追踪系统里查路径,一来一回,半小时就过去了。
说实话,我见过太多团队踩这个坑。觉得上了最火的工具,就算完成可观测性建设了。
根本不是。

真正能用的可观测性,核心是把指标、日志、链路这三类数据给打通成一张网。你看到某个指标出现异常波动,能不能一键跳转到对应的时间点的日志,顺着链路直接摸到出问题的那个节点,而不是在不同的系统之间反复横跳。
钱花了不少,工具堆了一堆,最后用得最多的功能还是告警短信。换谁谁不心疼?
其实落地的时候根本不用追求一步到位。就拿老周他们的电商场景来说,先把最核心的三条链路——下单、支付、物流回传——的trace打全,每个节点的耗时、返回码、上下文传递情况全记清楚,指标和日志直接关联到对应的traceID。就这一套做扎实,已经能解决80%的线上突发问题了。
别贪多。一开始就想把所有服务的所有指标全采集上来,存储成本蹭蹭往上涨,查询的时候慢得要死,最后没人愿意点开看,等于白搭。
别等崩了才想起来补可观测性的课
我前两年在河西接触过一个做本地理财的客户,印象特别深。当时他们抢监管的备案节点,整个项目组连轴转了三周,所有精力全扑在业务逻辑开发上,没人管埋点的事。
上线第一周,就出了问题。三个用户反馈赎回的资金没到账,财务对了三天的账,对不上。因为每笔赎回交易的上下游ID根本没串起来,你查用户端的记录,有赎回申请,查支付端的记录,没收到请求,查核心账务系统,不知道钱从哪儿扣的。
折腾了快两周才把问题理清楚。中间流失了多少对资金安全敏感的用户,根本算不清。
很多团队对可观测性的误解,就是把它当成项目上线之后的补丁。总觉得业务优先,等系统跑稳了,再慢慢补埋点,补链路。可实际上,没有可观测性托底的系统,你根本不知道它在哪个犄角旮旯藏着雷。
我自己的建议是,不管你现在的系统是新是旧,先从最容易出问题的核心链路开始补。不用搞什么花里胡哨的3D可视化大屏,不用给领导做什么汇报用的炫酷看板。就做最实在的事:当用户反馈”我点了付款没反应”的时候,你能顺着他的用户ID,30秒内摸到到底是哪个节点卡了,哪个环节报错了,这就够了。
老周现在每次上线新功能,第一件事就是先把对应链路的埋点检查一遍。上次吃粉丝的时候他说,现在再碰到异常,根本不用翻半宿日志,顺着链路点两下就找到问题了。
那碗粉丝他最后加了个卤蛋。