湖仓一体不是厂商吹出来的新物种
上个月去南京的一场数据行业闭门会,散场的时候被三个不同公司的技术总监拉住吐槽,说听了一下午的湖仓一体宣讲,越听越糊涂。
你被厂商的演示骗了多久
很多人对湖仓一体的第一印象,是厂商搭的那个完美demo:同一份底层数据,既能跑数仓的高并发报表,又能跑数据湖的机器学习训练,不用来回导数据,没有冗余,成本砍半。
扯呢。
真的在生产环境待过的人都知道,之前的架构是什么样的:数据湖存原始的非结构化、半结构化数据,跑批量的离线任务,灵活性拉满,但是查数慢,权限管不住,经常出现分析师拿错脏数据出报表的事故。数仓呢,把数据清洗建模之后存在结构化的表里,查数快,权限清晰,但是灵活性差,加个新字段要走半个月的流程,存个日志、图片这种非结构化数据比登天还难。两边中间隔了一层厚厚的数据同步链路,每个季度都要维护一堆ETL脚本,脚本坏了没人知道,等业务方发现报表数不对的时候,已经差了三天的数。
问题从来不是”我要选湖还是选仓”。是两边的缝越来越大,维护成本高到扛不住。
所谓一体,本质是缝补不是重建
好多厂商把湖仓一体吹成了从零开始替换所有旧系统的新架构,好像你把之前的数仓、数据湖全砸了,买一套新平台就完事了。真不是。
说白了,湖仓一体要解决的根本问题,是在原来的数据湖存储层上面,叠一层支持ACID事务、schema管控、权限隔离的数仓能力。不是让你把原来的数仓扔了,也不是让你把数据湖的灵活性全砍掉。
我上次碰到个做零售的技术负责人,说之前跟风上了一套吹得神乎其神的湖仓平台,把原来跑了五年的数仓全迁过去了,结果迁完才发现,平台对原来用的SQL方言兼容性只有60%,之前跑了上千个报表的逻辑,改了三个月还没改完,光临时找外包改代码的钱,就够原来三年的数仓维护成本了。
麻烦在于,很多人把”一体”理解成了”大一统”。好像一个平台能把所有数据场景全cover,从埋点采集到实时数仓到AI训练到BI展示,全给你包圆。哪有这种好事。
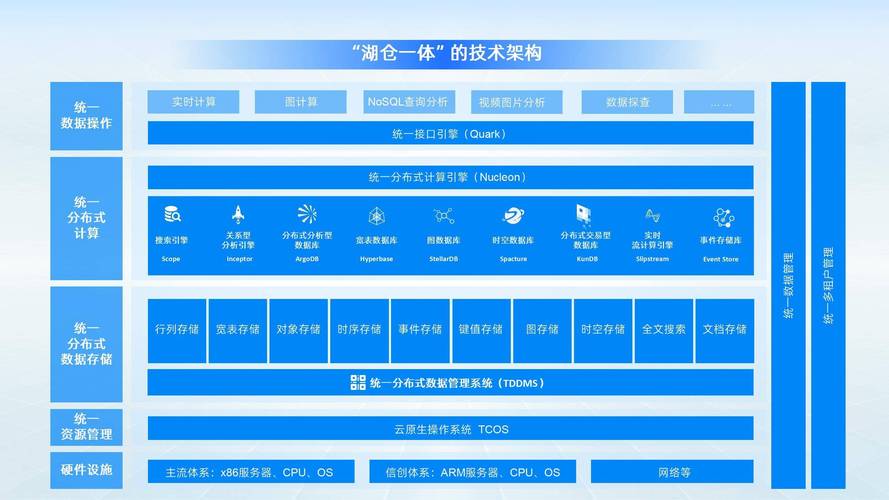
真的落地过湖仓一体的团队都知道,所谓的一体,是把之前两层之间的同步链路给消掉了。原来你要把数据从湖同步到仓,要写ETL,要算同步延迟,要处理两边数据不一致的问题。现在底层是同一份存储,上层既可以给数仓的BI任务用,也可以给数据湖的AI任务用,省下来的就是中间同步的那堆麻烦事。
别把技术选型算成一锤子买卖
好多人聊湖仓一体,上来就算ROI,说我上这个系统能省多少钱,能提多少效。算来算去全是厂商PPT上的数。
要讲代价的。你要在数据湖上面叠数仓的能力,不是天上掉下来的。你得有人把原来散在湖里面的表做schema梳理,得把原来乱糟糟的权限规则重新对齐,得把之前跑了好几年的任务逻辑慢慢迁移到新的层上。
没有捷径。
我见过最稳的落地路径,根本不是上来就大拆大建。是先从最痛的那个点切入:比如之前同步链路最容易断的那几个核心报表,先把数据挪到统一的湖存储层,在上面叠一层数仓的视图,先把同步的问题解决。跑个半年,稳了,再慢慢把别的场景迁过来。
别信什么”一步到位”的鬼话。技术架构从来都是跟着业务需求走的,不是跟着厂商的发布会走的。
说实话,这几年我见过太多追技术热点追翻车的团队了。今天听说流计算火,全团队去学Flink,明天听说数据网格火,又要拆成一堆域中心,后天听说湖仓一体是未来,又要把之前的系统全推翻。折腾来折腾去,业务没见涨多少,技术团队的加班时长倒是翻了倍。
湖仓一体本质上就是个解决实际问题的工具。它不是什么行业革命,也不是什么必须要追的风口。你要是现在的数据同步链路已经把团队折磨得够呛,数仓和湖之间的维护成本已经高到扛不住,那它确实能帮你省不少事。你要是现在的架构跑得好好的,一年到头也没几个导数据的故障,那犯不上为了蹭概念硬上。
对吧。