容器化不是开箱即用的魔法
上周跟做运维的老周在新街口喝鸭血粉丝汤,他说去年硬跟着行业风向推容器化,现在整个组天天救火。
他所在的公司算中型规模,业务系统加起来二十多个,之前跑在VMware的虚拟机上稳了快四年,每年发版次数一只手数得过来。去年新来的CTO说要跟互联网公司对齐,半年内所有系统必须全部迁到K8s集群。
这事没那么玄。
很多人对容器的认知,还停留在“启动快、省资源”的宣传话术里,根本没区分什么系统适合迁,什么系统迁了反而给自己找事。老周他们当时为了赶进度,直接把虚拟机里跑的老系统打包成容器镜像,连里面硬编码的本地磁盘路径、绑定宿主机端口的配置都没改。
传统虚拟机与容器资源占用对比示意图
上线第一周就出了三次大故障。有个跑了快十年的报表系统,原来在虚拟机里固定绑定本地的一块SSD存临时缓存,迁成容器之后,集群自动调度把实例分到了三个不同的节点上,每个节点的本地盘里存了一半的临时数据,最后报表直接算错了数,把财务给气的。
最核心的误区是把容器化当成了普适性的性能提升工具。那些被吹得神乎其神的资源节省比例,全是针对无状态服务测出来的——你把这种服务的实例随便调度到哪个节点上都能跑,不需要依赖本地存储,也不需要固定的网络标识。但你要是把有状态的数据库、依赖硬件加速的渲染服务、绑定了本地License的工业软件硬塞进去,光为了适配容器环境加的网络存储、设备映射、权限配置开销,算下来性能掉三成都是常事,省的那点服务器资源钱,还抵不上一次故障的业务损失。
麻烦在于。
大部分团队算容器化的投入账,只算看得见的服务器采购成本,完全不算那些藏在流程和人力里的隐性支出。老周他们组原来三个运维管二十台虚拟机,发版只要把安装包传到服务器上跑个提前写好的脚本就行,出了问题直接登服务器查日志,五分钟就能定位故障点。
现在为了维护这个K8s集群,他们专门招了两个有三年以上容器运维经验的工程师,开的工资比原来的老运维高了快一倍。原来开发半天就能搞定的发版,现在要写规范的Dockerfile,要做镜像漏洞扫描,要配CI/CD流水线,要给每个服务算好CPU和内存的资源配额,光这些配置工作,每次发版就要多耗小半天。
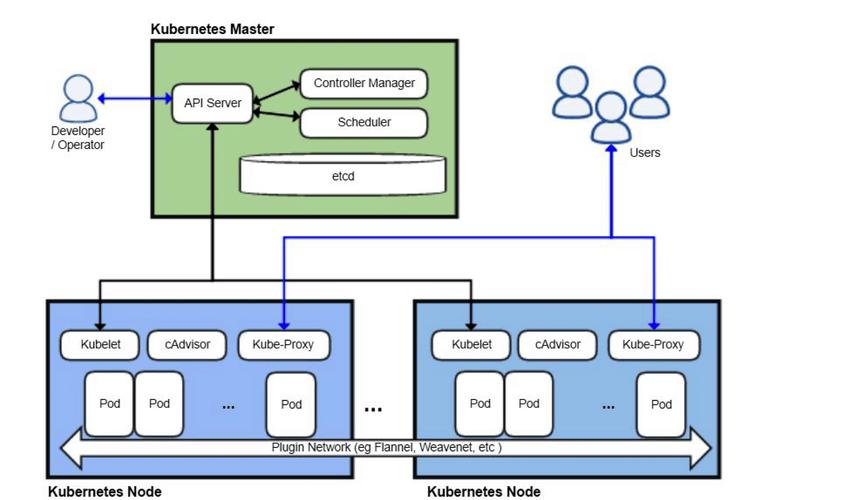
Kubernetes集群运维节点架构流程图
很多团队算投入产出的时候,直接把容器化的人力学习成本给漏了。原来的运维团队之前只接触过传统虚拟机,光是把K8s的核心概念、排障逻辑摸熟就要小半年,这半年里的效率下降,没人会算进项目成本里。还有网络排查的成本,原来服务之间都是内网直连,现在流量要过Service、过网关、过服务网格,原来五分钟能找到的网络问题,现在翻好几层日志、跨好几个组件排查,要耗半小时甚至更久,这些时间成本,全是看不见的支出。
我见过不少团队,搞容器化完全是为了跟风。
比如总共就三四个业务系统,一年发版不超过五次,系统跑在虚拟机上稳得不行,非要花几十万上容器平台,最后平台里跑的容器还没虚拟机多,纯粹是给运维加活。
容器化从来不是什么必选项。你要是遇到的问题是各个开发、测试、生产环境配置不一致,本地跑的好好的包到测试环境就报错,每天要发十几次版,大促的时候要快速扩缩容几百个实例,那这时候上容器化的价值才真的能落下来。
之前接触过一个做区域电商的团队,去年只把大促相关的无状态服务迁到了容器平台——平时跑固定的几个节点,大促的时候自动扩几百个实例扛流量,活动结束自动缩容,这部分的资源成本确实省了不少。但他们没硬迁老的库存系统,因为那个系统依赖本地分布式锁,迁容器反而要改一大块核心逻辑,索性就留在原来的虚拟机上跑,两边通过内网打通就行。
说白了,容器化就是个工具。
就像你不能拿螺丝刀去敲钉子,也不能为了用螺丝刀把家里所有东西都拆了重拼,工具的意义是解决你现在遇到的具体问题,不是让你为了用工具反过来给自己造一堆新问题。那些吹容器化能万能降本增效的话术,听听就好,真落地的时候,得先摸清楚自己的系统是什么属性,自己的团队能不能接得住这套体系,别脑子一热就全量迁,最后像老周他们一样,天天凌晨被集群告警叫起来救火。
上周老周说,现在他们把之前硬迁的三个老系统又迁回了虚拟机,剩下的十几个无状态服务留在容器里跑,现在终于不用天天熬夜处理告警了。
他所在的公司算中型规模,业务系统加起来二十多个,之前跑在VMware的虚拟机上稳了快四年,每年发版次数一只手数得过来。去年新来的CTO说要跟互联网公司对齐,半年内所有系统必须全部迁到K8s集群。
不是所有系统都配跑在容器里
这事没那么玄。
很多人对容器的认知,还停留在“启动快、省资源”的宣传话术里,根本没区分什么系统适合迁,什么系统迁了反而给自己找事。老周他们当时为了赶进度,直接把虚拟机里跑的老系统打包成容器镜像,连里面硬编码的本地磁盘路径、绑定宿主机端口的配置都没改。
上线第一周就出了三次大故障。有个跑了快十年的报表系统,原来在虚拟机里固定绑定本地的一块SSD存临时缓存,迁成容器之后,集群自动调度把实例分到了三个不同的节点上,每个节点的本地盘里存了一半的临时数据,最后报表直接算错了数,把财务给气的。
最核心的误区是把容器化当成了普适性的性能提升工具。那些被吹得神乎其神的资源节省比例,全是针对无状态服务测出来的——你把这种服务的实例随便调度到哪个节点上都能跑,不需要依赖本地存储,也不需要固定的网络标识。但你要是把有状态的数据库、依赖硬件加速的渲染服务、绑定了本地License的工业软件硬塞进去,光为了适配容器环境加的网络存储、设备映射、权限配置开销,算下来性能掉三成都是常事,省的那点服务器资源钱,还抵不上一次故障的业务损失。
容器化的隐性成本藏在看不见的地方
麻烦在于。
大部分团队算容器化的投入账,只算看得见的服务器采购成本,完全不算那些藏在流程和人力里的隐性支出。老周他们组原来三个运维管二十台虚拟机,发版只要把安装包传到服务器上跑个提前写好的脚本就行,出了问题直接登服务器查日志,五分钟就能定位故障点。
现在为了维护这个K8s集群,他们专门招了两个有三年以上容器运维经验的工程师,开的工资比原来的老运维高了快一倍。原来开发半天就能搞定的发版,现在要写规范的Dockerfile,要做镜像漏洞扫描,要配CI/CD流水线,要给每个服务算好CPU和内存的资源配额,光这些配置工作,每次发版就要多耗小半天。
很多团队算投入产出的时候,直接把容器化的人力学习成本给漏了。原来的运维团队之前只接触过传统虚拟机,光是把K8s的核心概念、排障逻辑摸熟就要小半年,这半年里的效率下降,没人会算进项目成本里。还有网络排查的成本,原来服务之间都是内网直连,现在流量要过Service、过网关、过服务网格,原来五分钟能找到的网络问题,现在翻好几层日志、跨好几个组件排查,要耗半小时甚至更久,这些时间成本,全是看不见的支出。
真要落地得先想清楚自己的核心需求
我见过不少团队,搞容器化完全是为了跟风。
比如总共就三四个业务系统,一年发版不超过五次,系统跑在虚拟机上稳得不行,非要花几十万上容器平台,最后平台里跑的容器还没虚拟机多,纯粹是给运维加活。
容器化从来不是什么必选项。你要是遇到的问题是各个开发、测试、生产环境配置不一致,本地跑的好好的包到测试环境就报错,每天要发十几次版,大促的时候要快速扩缩容几百个实例,那这时候上容器化的价值才真的能落下来。
之前接触过一个做区域电商的团队,去年只把大促相关的无状态服务迁到了容器平台——平时跑固定的几个节点,大促的时候自动扩几百个实例扛流量,活动结束自动缩容,这部分的资源成本确实省了不少。但他们没硬迁老的库存系统,因为那个系统依赖本地分布式锁,迁容器反而要改一大块核心逻辑,索性就留在原来的虚拟机上跑,两边通过内网打通就行。
说白了,容器化就是个工具。
就像你不能拿螺丝刀去敲钉子,也不能为了用螺丝刀把家里所有东西都拆了重拼,工具的意义是解决你现在遇到的具体问题,不是让你为了用工具反过来给自己造一堆新问题。那些吹容器化能万能降本增效的话术,听听就好,真落地的时候,得先摸清楚自己的系统是什么属性,自己的团队能不能接得住这套体系,别脑子一热就全量迁,最后像老周他们一样,天天凌晨被集群告警叫起来救火。
上周老周说,现在他们把之前硬迁的三个老系统又迁回了虚拟机,剩下的十几个无状态服务留在容器里跑,现在终于不用天天熬夜处理告警了。