性能压测场景设计与数据构造 别拿线上数据硬凑数
上个月帮杭州一个电商团队救火。
他们攒了三周的压测方案,618前最后一轮全链路压测,刚跑5分钟,核心订单库直接锁死。运维兄弟拍着桌子骂,说之前测了七八轮都好好的,怎么临到要上线就崩?
查了半小时日志才发现问题——他们图省事,压测环境的库是直接从生产全量导的,连过去三年的历史订单都没筛。压测脚本里的“热门商品订单查询”逻辑,本来线上大促时用户只会点最近30天的订单列表,结果压测时扫了全库几亿条历史数据,索引完全失效,直接全表扫描把库干到100%CPU。
别拿生产数据直接当压测素材
很多团队做压测,第一步就踩坑。总觉得生产数据最真实,导过来就能用,省得自己造数据麻烦。
错得离谱。
生产数据的分布,和你要模拟的峰值场景完全不是一回事。平时线上的用户,70%是刷商品不买单,20%加购,10%下单,这个比例放在日常没问题,但大促峰值时,下单占比能冲到30%以上。你要是直接按生产的用户行为分布去压,根本测不到峰值时的下单、扣库存、支付链路的压力。
更别说生产数据里混着多少脏数据:测试期瞎填的无效手机号、已经下架半年的商品ID、触发风控的异常用户。这些数据会让压测跑到一堆根本不存在的异常分支,测出来的QPS、响应时间,半毛钱参考价值都没有。
直接导全量生产数据,本质上是在给压测埋雷。上次那个团队就是,导的数据里有近10万条已经被风控的异常账号,压测刚启动,风控系统就触发了全量拦截,所有请求直接打回,白跑了3天的测试。
场景设计别只盯着接口QPS
还有个更常见的误区。
很多团队做压测,就是把平时QPS最高的几个接口拉出来,按10倍峰值打,跑半小时,看接口响应时间达标就收工。根本不管真实用户的行为链路是什么样的。
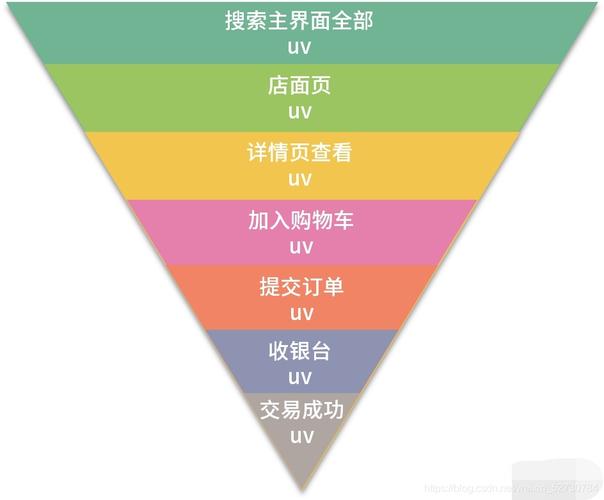
你想想,大促时用户的操作路径是啥?打开首页,刷3轮商品列表,点进3个商品详情,加购1次,蹲点抢券,抢完券跳订单页,填地址,提交,支付。这个链路里的压力根本不是均匀的。抢券的那一秒,1000个用户同时点抢券按钮,这时候订单接口的QPS其实还没上来,但抢券接口对应的库存行锁竞争,已经能把数据库拖垮。
之前那个电商团队就是,之前测了七八轮,只盯着订单提交接口的QPS打,根本没测抢券环节的库存扣减逻辑。结果全链路压测时,抢券接口出现超卖,直接触发熔断,整个下单链路全断。
真的亏。
数据构造要跟着真实流量画像走
说实话,压测这事没有捷径。你要想测出来的结果能真的扛住线上峰值,就得把数据和场景都摸得明明白白。
先去拉最近3次同级别大促的用户行为日志,把流量分布算清楚:首页访问占多少,商品详情页占多少,加购占多少,抢券占多少,下单占多少,支付占多少。再按这个比例去编排压测脚本,别瞎拍脑袋定QPS比例。
数据构造也一样。别图省事全导生产,先把无效的历史数据、脏数据、异常账号全删掉,留最近3个月的活跃用户、有效商品、正常订单数据就行。要是测峰值场景,就再按比例构造对应的测试数据:比如10万并发的首页访问,就得提前准备好10万个不同类目、不同价格带的商品数据,不能全是统一的测试商品,不然缓存命中率和真实场景差太远,测出来的接口响应时间根本不准。
还有个小细节——别用同一个用户ID打所有接口。上次见有个团队的压测脚本,所有请求都用同一个测试账号,结果压测跑了10分钟,这个账号的操作日志把日志系统直接撑爆,查了半天才找到问题。真的,这种坑踩一次就够记一辈子。
后来帮那个电商团队改完方案,把三年的历史订单全清掉,只留30天的有效数据,再按真实的用户行为链路编排脚本,跑20万并发的时候,核心接口响应时间稳在200ms以内,数据库CPU也没超过70%。
别总觉得压测是测试或者运维的事。
业务不参与进来,测出来的结果,全是自嗨。