摸过三年脏数据才懂的数据治理
上周去南京软件大道找个做零售的朋友蹭咖啡,他拉着我吐槽了半小时——刚上线的用户复购分析报表,数了三遍数出来三个完全不一样的结果。
问题出在哪?
不是数仓的算力不够,是数据治理的事没做透。
企业数仓日常运维排查脏数据场景实拍 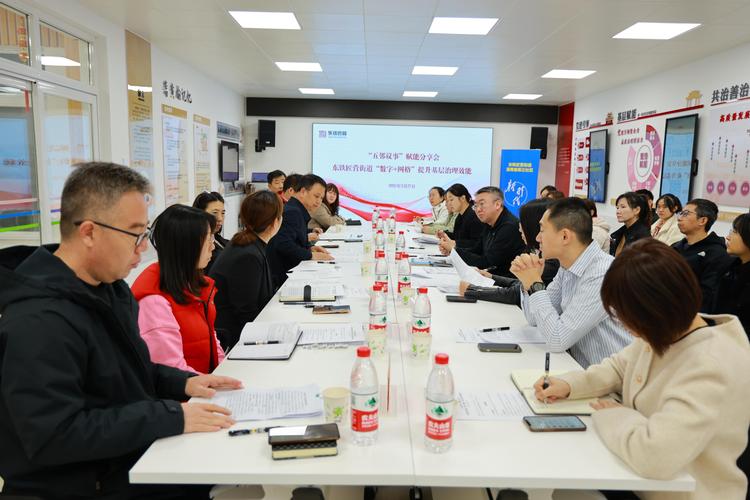
跨部门数据治理规则对齐会议现场
别把数据治理当买工具的一锤子买卖
很多公司一提数据治理,第一反应是找个厂商买套系统,装完就贴个”已完成数字化转型”的标签,贴完就不管了。说白了,这跟你花大价钱买了个高端扫地机器人,结果从来不给它倒尘盒、换滤芯,最后它扫出来的地比不扫还脏,有什么区别?别盯着完美主义,先把最影响干活的窟窿堵上
很多人对数据治理的误解,是要把所有数据都做到100%准确、全链路可追溯、每个字段都有统一的口径定义。这事没那么玄,真要这么干,你算下投入的人力和时间成本,估计老板第一个跳起来反对。 之前接触过的一个做制造的团队,一开始想把过去十年的所有生产设备的传感器数据全梳理一遍,从设备编号的命名规则,到每个传感器的采集频率,再到异常值的判定标准,全拉了个二十多页的文档,开了三次跨部门会,吵了快俩月,连第一阶段的计划都没定下来。后来他们换了个思路,先不搞全量梳理,就盯着现在最影响生产排程的那三个核心数据字段——设备开机率、故障上报时间、物料匹配度,把这三个字段从采集端到报表端的全链路口径先统一,谁要改字段规则必须提前在公共看板上公示,两周就把之前经常出现的排程错配问题解决了。